

DeepSeek-V3
DeepSeek-V3 a été pré-entraîné sur un ensemble de données massif de 14 800 milliards de tokens, suivi d'étapes de réglage fin supervisé et d'apprentissage par renforcement pour exploiter pleinement ses capacités. Il s'appuie sur l'architecture Mixture-of-Experts développée pour son prédécesseur, DeepSeekMoE, composée comme son nom l'indique, de divers experts spécialisés. Ces derniers sont activés selon les besoins spécifiques des requêtes grâce à un mécanisme de routage intelligent, ce qui permet au modèle de gérer efficacement une variété de tâches tout en réduisant la charge computationnelle. Il adopte également son architecture innovante Multi-head Latent Attention (Attention Latente Multi-têtes ou MLA), une approche qui permet de compresser de manière conjointe les clés et les valeurs d'attention, diminuant ainsi la taille du cache Key-Value (KV) pendant l'inférence. Elle réduit l’utilisation de la mémoire à 5-13 % de celle requise par l’architecture MHA couramment utilisée, améliorant l'efficacité du traitement tout en maintenant une performance élevée. Pour assurer une répartition équilibrée de la charge entre les experts, DeepSeek-V3 intègre une stratégie de load balancing sans perte auxiliaire. Cette méthode garantit une utilisation optimale des ressources sans compromettre la performance du modèle. Ce dernier hérite également des capacités avancées de raisonnement de la série DeepSeek R1, qui reposent comme OpenAI o1 et le modèle o3, sur la chaîne de pensée (chain of thought), ce qui lui permet d'exceller dans les tâches complexes nécessitant un raisonnement structuré.Les performances du modèle
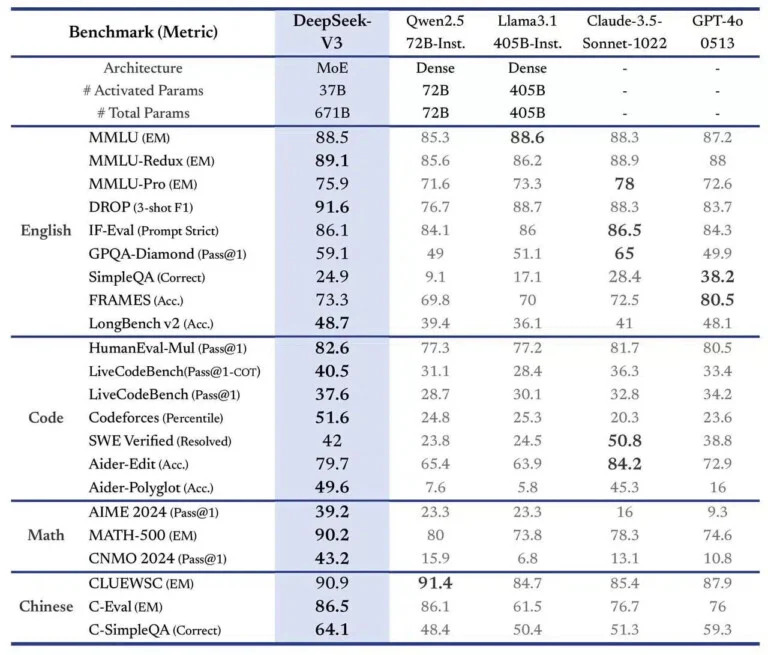
DeepSeek-V3 est trois fois plus rapide que son prédécesseur, avec une capacité de traitement de 60 tokens par seconde. Selon les benchmarks partagés par la start-up, il se classe en tête des modèles open source et rivalise avec les modèles propriétaires les plus avancés dans divers domaines, notamment la compréhension linguistique, le raisonnement mathématique et la génération de code. Il obtient non seulement le meilleur score (51,6) sur Codeforces, mais est également avec 90,2 % clairement en tête du benchmark de MATH-500 surpassant Llama 3.1 (73,8 %), Claude-3.5 (78,3 %) et GPT-4o (74,6 %).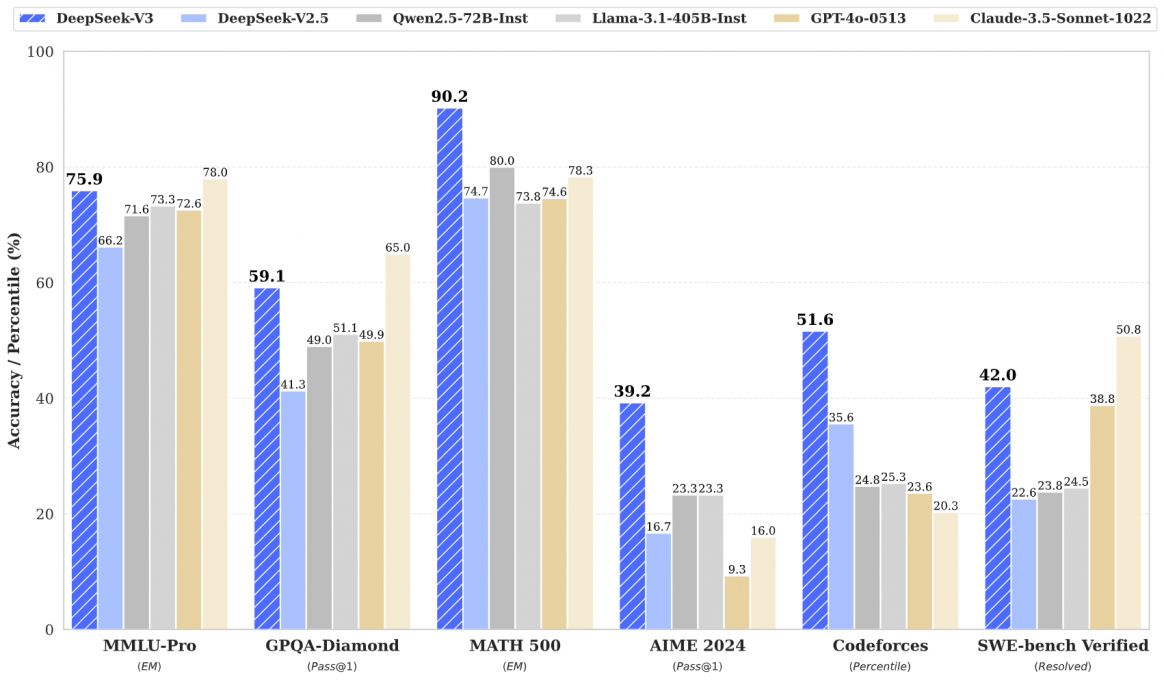
 Comme tous les LLMs chinois, le modèle a reçu une approbation officielle avant son lancement, garantissant son adéquation aux valeurs socialistes et à l'idéologie chinoises. Il évite donc certains sujets sensibles.
Une interface intuitive, similaire à celle de ChatGPT, incluant un moteur de recherche en temps réel, permet d'interagir avec le modèle sur le site de DeepSeek. Pour les entreprises, la start-up propose une API à des tarifs très compétitifs : 0,27 $ par million de tokens en entrée, 1,10 $ par million de tokens en sortie.
Le modèle est téléchargeable sur Hugging Face. Le code complet ainsi qu'une documentation technique détaillée sont quant à eux disponibles sur GitHub.

Nos articles remonteront en priorité dans « À la une » de Google.