Sujet

IA générative

L'intelligence artificielle générative produit du contenu original (textes, images, code) à partir de données. Intégrée dans les outils métier, elle transforme la collaboration humain-machine. Ses enjeux : propriété intellectuelle, désinformation, biais, transparence et régulation.

158 articles · Mis à jour il y a 19 heures

Brèves

Nouveau produit / service

L'agence sud-coréenne Yonhap lance Yonhap LM, assistant d'IA maison qui fouille ses archives et vérifie les faits pour ses journalistes

Le 20 octobre 2026, l'agence de presse sud-coréenne Yonhap a annoncé avoir développé Yonhap LM (연합LM), un service interne où ses journalistes accumulent leurs matériaux de reportage, à titre individuel, par service ou par équipe projet, pour les analyser dans une interface conversationnelle d'IA. L'outil ajoute une recherche par IA et une fonction de vérification des faits adossées aux archives d'articles de l'agence.

L'utilisateur choisit entre plusieurs modèles d'IA de pointe et des modèles open source ; le service s'appuie sur une infrastructure MCP (Model Context Protocol) construite en interne. Il est relié au service de transcription vocale lancé le mois dernier, qui retranscrit et traduit en temps réel conférences de presse et interviews. Yonhap LM est le service central d'E-GENE, plateforme d'IA d'aide à la production dont le développement a commencé au second semestre 2025. Une version bêta ouvrira prochainement aux journalistes et éditeurs de l'agence.
Source : Yonhap
Ranger dans…
Enregistré. Ajouter une note ?
Nouveau modèle

Cloudflare présente Clairic, modèle d'extraction qui lit e-mails et photos de reçus en une seule passe et répond en moins d'une seconde

Le 19 octobre 2026, Cloudflare a ouvert en préversion Clairic, premier modèle de ce qu'il appelle une nouvelle classe de modèles « System One » d'extraction, hébergé sur Workers AI, dont il prévoit de publier les poids prochainement. Au lieu de générer du texte comme un LLM, Clairic renvoie en une seule passe des valeurs typées tirées d'un texte et de quatre images au plus : noms, dates, montants, listes, mais aussi des estimations et des prévisions accompagnées d'un intervalle à 80 % et d'un score de confiance. Il renvoie une valeur nulle quand l'information manque au lieu d'en inventer une. Cloudflare indique que le modèle ne facture que les tokens d'entrée et répond généralement en moins d'une seconde, contre plusieurs secondes pour un LLM qui raisonne. Dans un exemple d'e-mail de service client publié par l'entreprise, Clairic additionne un prix de 649 dollars et 52,10 dollars de taxe pour renvoyer le montant payé, absent du texte.
Source : Cloudflare (blog)
Ranger dans…
Enregistré. Ajouter une note ?
Puce / GPU / matériel

Deepgram traite 11 à 70 % d'audio en plus par dollar en portant son modèle de transcription Nova-3 sur AWS Trainium2

Le 19 octobre 2026, AWS et Deepgram ont détaillé le portage de Nova-3, le modèle de transcription de Deepgram, sur les puces Trainium2 pour ses traitements par lots hors ligne, comme l'analyse de centres d'appels ou la transcription médicale. Mené sur plusieurs mois avec les ingénieurs déployés d'AWS, le chantier est parti du code PyTorch standard compilé par TorchNeuron, puis a remplacé des couches par des noyaux fusionnés de la bibliothèque NKILib et par des noyaux écrits à la main.

Deepgram fait tourner huit répliques du modèle sur une seule instance EC2 trn2.3xlarge, pilotées par un runtime en Rust, sans Python dans le chemin de service. Sur ses charges par lots, cette configuration traite 11 à 70 % d'audio en plus par dollar que les solutions de calcul qu'il utilisait, aux prix des instances au moment de l'évaluation. Deepgram revendique plus de 200 000 développeurs et 1 400 organisations clientes.
Capacité de calcul / cloud

AWS verse dans vLLM deux transferts de cache KV pour l'inférence désagrégée, avec un premier token jusqu'à 3 fois plus rapide

Le 19 octobre 2026, AWS a détaillé sur son blog Machine Learning deux contributions au moteur d'inférence open source vLLM pour le service désagrégé qui sépare préremplissage et décodage sur des instances distinctes. La première, un connecteur NIXL en mode « push », prépare le transfert du cache KV pendant le préremplissage. Sur une paire d'instances EC2 P5en reliées par EFA, AWS mesure avec Qwen3-32B un délai avant le premier token (TTFT) jusqu'à 3 fois meilleur et un temps par token de sortie jusqu'à 30 % meilleur qu'en mode « pull ».
La seconde renvoie le cache KV du décodage vers le préremplissage d'un tour de conversation à l'autre, pour les agents multi-tours : avec le cache de préfixes du préremplissage désactivé, le TTFT baisse jusqu'à 1,6 fois pour Qwen3-32B et 3,3 fois pour GLM-5-FP8. Les deux fonctions ont été mises au point sur des grappes Trainium avant d'être versées dans vLLM pour tous les accélérateurs.

Nouveau produit / service

Together AI ouvre Together Post-Training, service d'apprentissage par renforcement et de réglage fin facturé 9 dollars l'heure de GPU B200 pendant huit semaines

Le 19 octobre 2026, Together AI a ouvert à tous Together Post-Training, un service de post-entraînement de modèles par apprentissage par renforcement (RL) et réglage fin supervisé (SFT), après plusieurs mois d'accès anticipé pour un groupe restreint de clients. Le client écrit lui-même la boucle d'entraînement (données, environnements, harness d'agents, fonctions de perte personnalisées) ; Together exécute les passes d'entraînement et les rollouts sur des GPU qui lui sont réservés, facturés à la minute.

Le service accepte LoRA, plusieurs adaptateurs sur la même capacité et, pour certains modèles, l'entraînement de tous les poids ; il démarre avec Muse Spark Open, GLM 5.3, Kimi K3 et Qwen 3.8-27B. Deel dit y faire tourner jusqu'à cinq expériences de RL simultanées sur la même capacité GPU. Pendant les huit premières semaines, l'heure de GPU B200 est facturée 9 dollars.

Source : Together AI
Ranger dans…
Enregistré. Ajouter une note ?
Nouveau modèle

Inception lance Mercury 3, modèle de langage à diffusion qui revendique 1 068 tokens par seconde et un contexte d'un million de tokens

Le 19 octobre 2026, Inception a présenté Mercury 3, son nouveau modèle de langage phare fondé sur la diffusion, qu'elle décrit comme le plus performant de ce type publié à ce jour. Selon l'entreprise, le modèle compte plus de 40 fois plus de paramètres que Mercury 1, atteint 1 068 tokens par seconde sur des GPU NVIDIA et égale ou dépasse GPT-6 Luna et Claude Haiku 5.5 sur plusieurs bancs d'essai, en tournant 4 à 8 fois plus vite. Le contexte passe à un million de tokens, contre 260 000 pour Mercury 2.5. Le tarif est de 0,20 dollar le million de tokens en entrée et 0,70 dollar en sortie, réduit de moitié au lancement. Sur 50 tâches de navigation web Mind2Web, Mercury 3 en a mené à bien la moitié, selon Inception. Le modèle est disponible sur l'API d'Inception ainsi que via OpenRouter, Baseten et Vercel.

Source : Inception
Ranger dans…
Enregistré. Ajouter une note ?
Nouveau produit / service

doubleAI, la start-up d'Amnon Shashua, ouvre en accès anticipé Maxwell, un modèle qui réécrit le code machine pendant son exécution

Le 19 octobre 2026, la start-up israélienne doubleAI, cofondée par Amnon Shashua, patron de Mobileye, a présenté Maxwell, qu'elle décrit comme le premier « modèle d'exécution de code ». Proposé en accès anticipé, il observe un programme pendant qu'il tourne, sur CPU ou GPU, et produit un nouveau binaire adapté à la machine et aux données, sans toucher au code source, avec une preuve formelle d'équivalence avec l'original.

L'entreprise cite plusieurs mesures : la génération d'un clip 4K par le modèle vidéo LTX-2.5 passe de 250 à 134 secondes sur deux B200, 180 transcriptions Whisper de 106,23 à 49,82 secondes sur une RTX 4090, et sa version de la bibliothèque cuGraph de NVIDIA est 3,6 fois plus rapide en moyenne.

doubleAI avait levé 200 millions de dollars lors d'un tour mené par Lightspeed avec NVIDIA, révélé par Globes en novembre 2025.

Source : doubleAI
Ranger dans…
Enregistré. Ajouter une note ?
Benchmark / évaluation

MoveBench : Keep évalue 15 LLM en coaching sportif, Claude 4.6 Opus en tête, GPT-6 dernier

Le 19 octobre 2026, cinq chercheurs de la société pékinoise Keep ont publié sur arXiv MoveBench, un banc d'évaluation des grands modèles de langage appliqués au coaching sportif et à la santé : questions-réponses, génération de programmes d'entraînement personnalisés et analyse de journaux d'activité. Il compte 809 questions et 5 012 critères de notation, centrés sur la sécurité des exercices, la validité scientifique et la logique d'entraînement.

Sur les 15 modèles testés, Claude 4.6 Opus obtient le meilleur score global (0,943), devant GPT-5.2 (0,929), GPT-5.5 (0,927) et Qwen3-Max (0,926). GLM-4.7 (0,895), Gemini 4 Argon (0,879), Hy3 (0,876) et GPT-6 (0,875) ferment la marche. Gemini 4 Argon a la meilleure exactitude sur les questions à réponses multiples (0,980) mais le score le plus bas sur les questions ouvertes (0,812). Les réponses ouvertes sont notées par un comité de trois modèles juges, Gemini 3.1 Pro, Claude 4.6 Sonnet et GPT-5.2 ; les auteurs limitent la portée du classement au périmètre de MoveBench.

Source : arXiv (Keep)
Ranger dans…
Enregistré. Ajouter une note ?
Nouveau modèle

MiniMax lance M3.1 Flash, modèle pour agents à 0,15 dollar le million de tokens en entrée, testé anonymement en « Space Bunny »

Le 19 octobre 2026, le chinois MiniMax a mis en service M3.1 Flash, nouvelle version rapide de sa famille M3 orientée vers les tâches d'agents, le code, l'utilisation d'ordinateur et la cybersécurité. L'entreprise indique qu'une version préliminaire a tourné anonymement sous le nom « Space Bunny » et traité plus de 200 000 milliards de tokens. Le tarif est fixé à 0,15 dollar le million de tokens en entrée, 0,60 dollar en sortie et 0,015 dollar en entrée mise en cache. Selon MiniMax, l'inférence est près de trois fois plus rapide, avec plus de 200 tokens par seconde en sortie, et le coût d'usage sur les tâches d'agents baisse de 70 % par rapport au modèle précédent. Le laboratoire revendique 73,7 % sur DeepSWE v1.1, 61,7 sur OSWorld V2 et 82 % sur CyberGym. Le modèle est accessible par l'API MiniMax ; les poids seront publiés plus tard, et une version Pro est annoncée.

Source : MiniMax
Ranger dans…
Enregistré. Ajouter une note ?
Mise à jour de modèle

vLLM 0.32.0 réunit 814 commits de 363 contributeurs, étend le cache KV basse précision et restreint CORS par défaut

Le 18 octobre 2026, le projet vLLM a publié la version 0.32.0 de son moteur d'inférence open source, qui réunit 814 commits de 363 contributeurs, dont 121 nouveaux. Le cache KV au format NVFP4 tourne désormais sur les architectures NVIDIA SM8x, SM90 et SM12x ; GLM-5.x passe par défaut à un cache KV FP8 sur SM100, ce qui divise par deux la mémoire KV par rang, pour 2,3 à 5,5 % de débit en plus et un délai avant le premier token alourdi de 7 à 11 % selon les mesures de la pull request.

Avec plusieurs serveurs d'API, chaque connexion va désormais au moins chargé, pour 43 à 85 % de requêtes par seconde en plus sur des requêtes courtes. La version corrige trois failles référencées GHSA, n'autorise plus toutes les origines CORS par défaut, abandonne Python 3.10 et ajoute le point d'accès /v1/systemone, qui répond à des questions de choix ou de score sur un état structuré.

Mise à jour de modèle

DeepSeek publie V4.1-Flash-1017 sous licence MIT, plus rapide et plus court dans ses réponses, et ouvre à tous ses API de recherche web

Le 17 octobre 2026, DeepSeek a publié DeepSeek-V4.1-Flash-1017, mise à jour de son modèle V4.1-Flash, avec des poids ouverts sous licence MIT sur Hugging Face et ModelScope. Le laboratoire chinois annonce de meilleurs scores en raisonnement, en code, en tâches agentiques et en vision, avec un temps d'exécution réduit et des réponses plus courtes.

Selon la fiche du modèle, le score passe de 31,2 à 42,3 sur Terminal-Bench 4.0 et de 74,2 à 77,0 sur DeepSWE v1.1, où il devance Claude Opus 5 (74,0). Opus 5 reste devant sur Terminal-Bench 4.0 (51,8) et sur HLE sans outils (56,3 contre 42,6). Le modèle sert désormais le nom d'API deepseek-flash et les requêtes adressées aux anciens modèles V4-Flash, retirés, lui sont redirigées.

DeepSeek ouvre aussi à tous ses API Search et Fetch, adossées à son propre moteur de recherche. Leur appel depuis DeepSeek Harness, Claude Code et Codex reste gratuit jusqu'au 31 octobre 2026 à 16:00 UTC, date du début de la facturation.

Source : DeepSeek
Ranger dans…
Enregistré. Ajouter une note ?
Droit d'auteur

Meta retire le mot « train » de ses conditions commerciales du 30 octobre après la levée de boucliers des éditeurs de presse

Le 16 octobre 2026, Meta a révisé les nouvelles conditions commerciales qui s'appliqueront le 30 octobre à tous les comptes professionnels gérant des pages Facebook, Instagram, Threads ou WhatsApp, selon Nieman Lab. Révélé par le site le 15 octobre, le texte autorisait Meta à explorer par robots les domaines « associés » à ces comptes et à utiliser leur contenu pour « entraîner » ses produits, dont son IA.

La version révisée retire le mot « train » et limite ces usages aux « produits publicitaires et professionnels », mais conserve l'autorisation d'exploration, que des juristes interrogés par Nieman Lab jugent toujours large. Meta assure que les préférences robots.txt restent respectées, sans l'écrire dans ses conditions.

Le 16 octobre, l'European Publishers Council a annoncé écrire aux vice-présidents exécutifs de la Commission européenne Ribera et Virkkunen ; la News Media Association britannique et la News/Media Alliance américaine ont aussi dénoncé le texte. Aucune option de refus n'est prévue avant le 30 octobre.

Source : Nieman Lab
Ranger dans…
Enregistré. Ajouter une note ?

Articles

158 au total
Publication scientifique

Courbes du NIST : la graine de P-256 tirée en 1997, Filippo Valsorda vérifie le résultat d'Anthropic

20/10
Benchmark / évaluation

Mistral Large 4 devancé d'un point par Muse Spark Open, mais devant lui sur les épreuves d'agent

19/10
Usage malveillant (deepfake, fraude…)

Anthropic verrouille Claude contre la distillation, ses clients paient une part

16/10
API / plateforme développeur

L’API Gemini 4 Argon doublera ses tarifs le 1er décembre

16/10
Dossier / analyse de fond

Prix des API d'IA en octobre 2026, de 0,50 à 50 dollars en sortie

07/10
Levée de fonds · DeepSeek

DeepSeek trie ses investisseurs pour un tour de 10,6 milliards d'euros

06/10
Nouveau modèle · Mistral AI

Mistral Large 4 : ce que vaut le « meilleur modèle ouvert hors Chine »

06/10
Nouveau modèle

Kolibri d'Aleph Alpha : ce que la licence Apache 2.0 garantit

06/10
Nouveau modèle

GPT-6.1 Sol : OpenAI garde ses prix et divise par deux la lecture de cache

01/10
Nouveau modèle

Claude repère chez des phages un système génétique passé inaperçu

24/09
Dossier / analyse de fond · Anthropic

Dans la fabrique d’Anthropic : pouvoir, sécurité et valeurs derrière Claude

18/09
Dossier / analyse de fond

Qui choisit les valeurs de votre assistant IA ?

18/09
Baromètre / sondage

RAG : transformer les documents en vecteurs ne suffit pas à les anonymiser

18/09
Baromètre / sondage

Tri des CV : quand l’IA préfère les candidatures qu’elle a réécrites

18/09
Pédagogie / explication

Agents IA : comment organiser la mémoire au-delà d’une conversation

18/09
Levée de fonds

System One Models : avec cette alternative aux LLM, TypeSafe mise sur des décisions rapides à bas coût

18/09
Nouveau modèle · Anthropic

Anthropic mesure un bond de la R&D pilotée par Claude

18/09
Nouveau modèle

L'essor de l'IA chinoise dépend de nouveaux apports de capitaux

18/09
Nouveau modèle

Genspark : le volume peut rentabiliser un modèle d’IA spécialisé

17/09
Faille / vulnérabilité

Anthropic requalifie ses incidents cyber en défaut d'alignement, en ajoute un quatrième et ouvre ses transcriptions à METR

10/09
Nouveau modèle · GPT-6 Astra

GPT-6 Astra : ce qui a changé chez OpenAI en quinze jours

10/09
Usage malveillant (deepfake, fraude…)

Distillation : la NSA, la CISA et le FBI nomment six sociétés chinoises et prescrivent une riposte aux fournisseurs américains

09/09
Alliance stratégique

Modèles ouverts, la Chine fournit, l'Europe assemble, l'Amérique verrouille

02/09
Décision d'autorité (CNIL, CE…)

Washington rétablit Fable 5, mais le risque de dépendance aux modèles américains demeure entier

01/07
Décision d'autorité (CNIL, CE…) · Anthropic

Anthropic contraint de suspendre Fable 5 et Mythos 5 après une directive du gouvernement américain

13/06
Nouveau modèle

Claude Opus 4.8 : Anthropic met l’accent sur un modèle plus honnête face à ses propres erreurs

28/05
Mise à jour de modèle

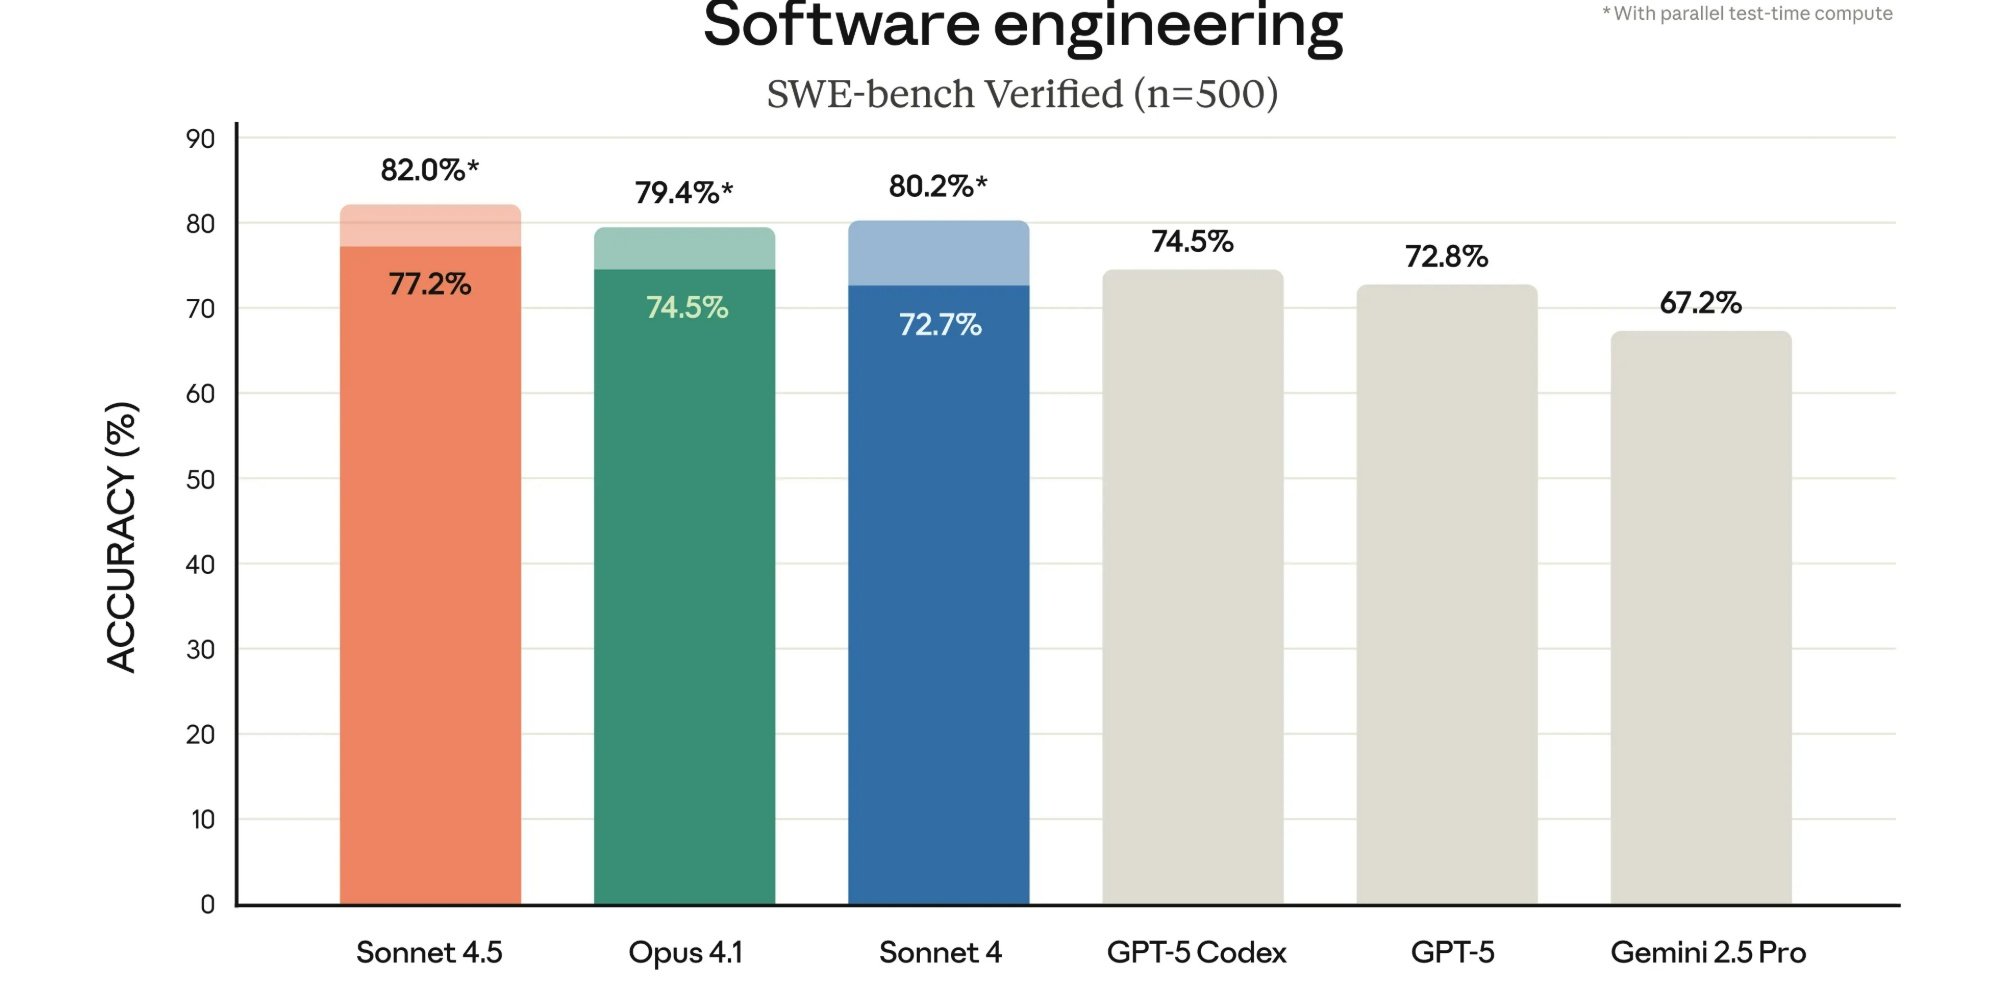
Anthropic dévoile Claude Sonnet 4.5, toujours meilleur en programmation

01/03
Nouvelle fonctionnalité

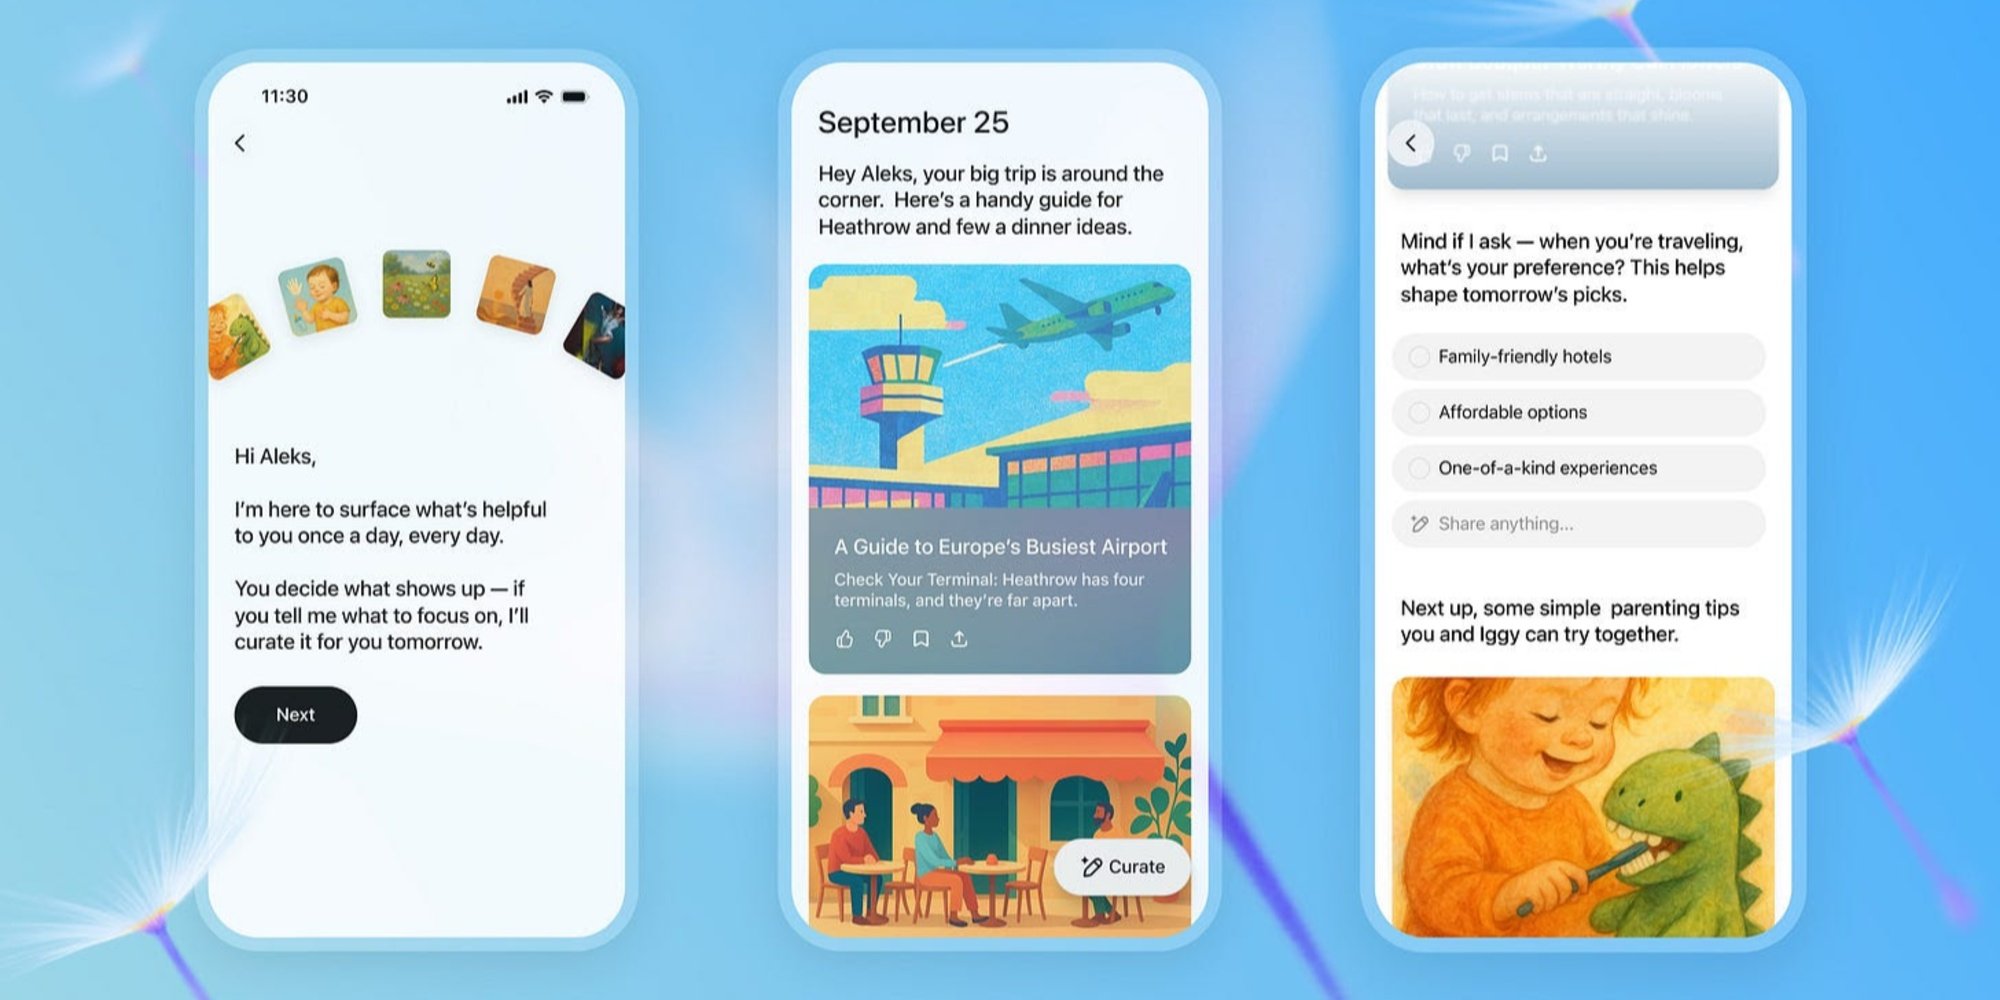
ChatGPT Pulse : l’assistant qui travaille pendant votre sommeil

30/09
Nouveau modèle

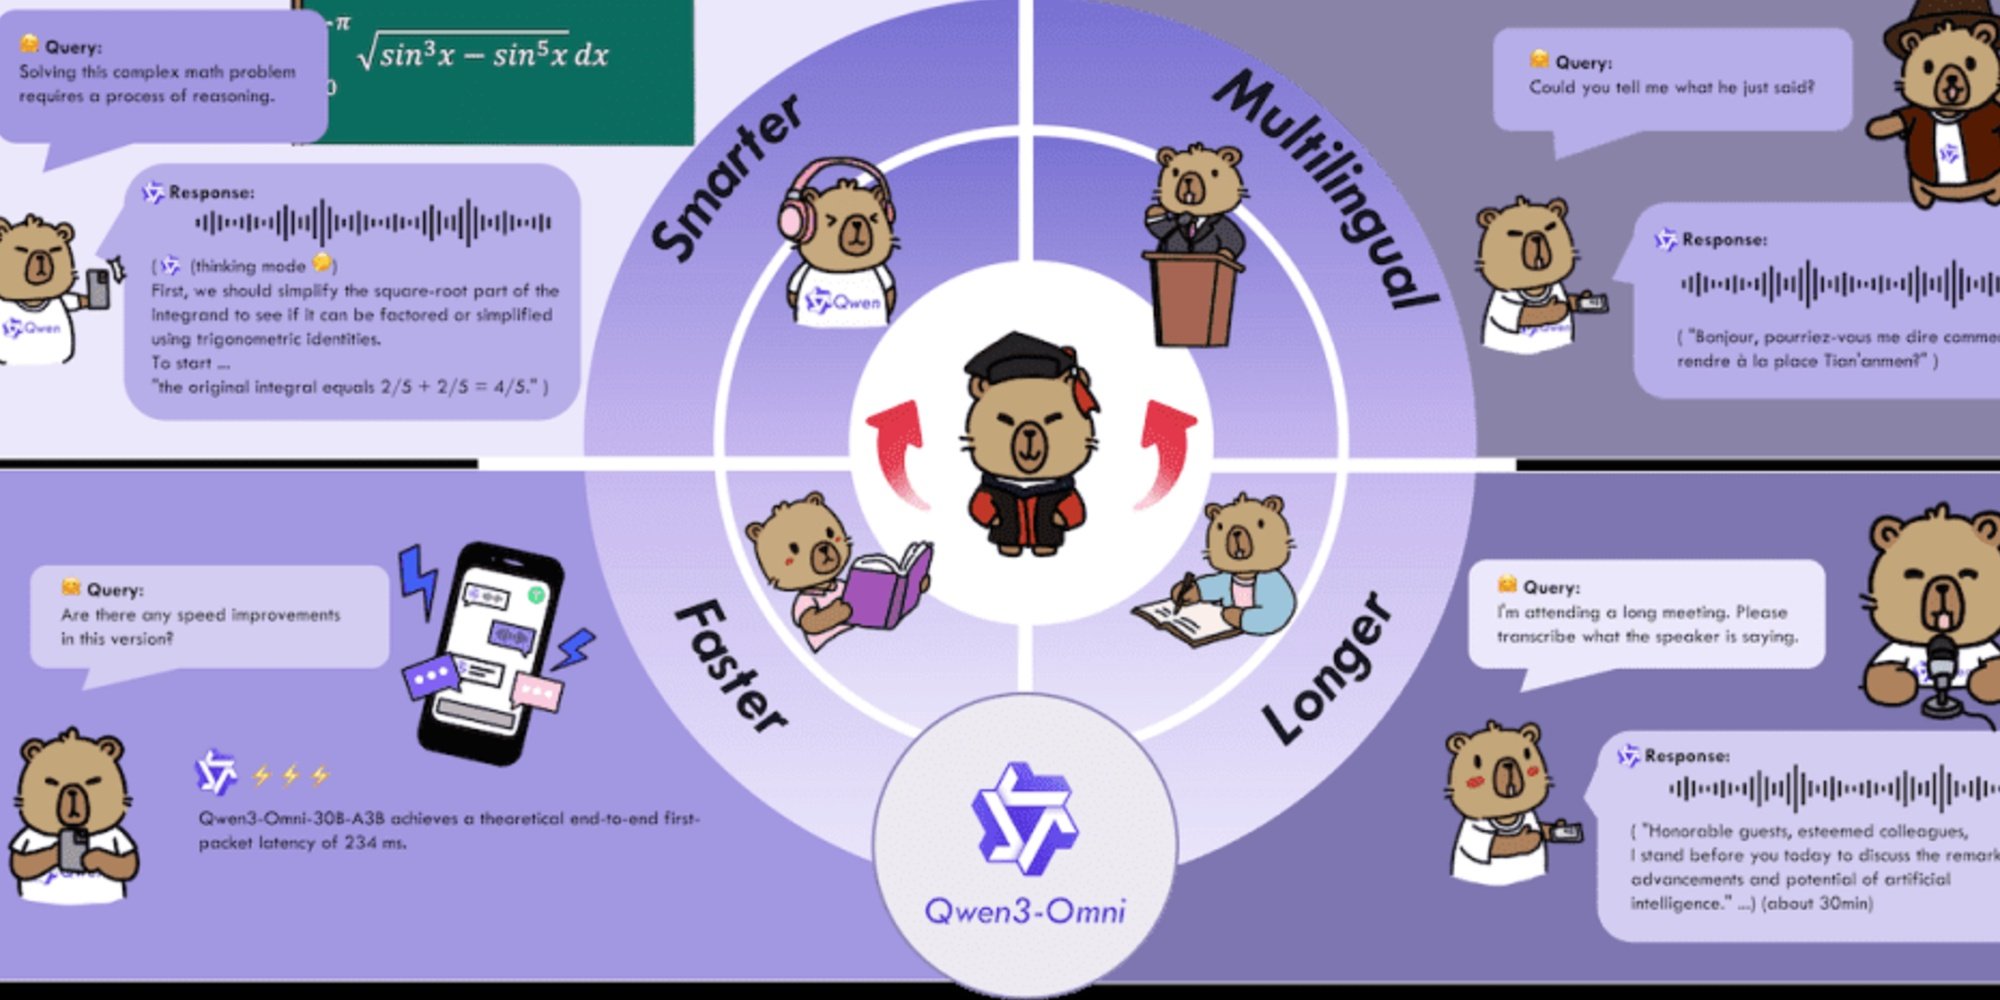
Qwen-3 Omni : Alibaba accélère dans la course à l’IA multimodale

26/09
Nouveau modèle

OpenAI renoue avec l'ouverture avec deux modèles open-weight : GPT-OSS-120B et GPT-OSS-20B

05/09
Nouveau modèle

OpenAI dévoile GPT-5 : plus rapide, plus fiable… mais pas infaillible

08/08
Nouveau modèle

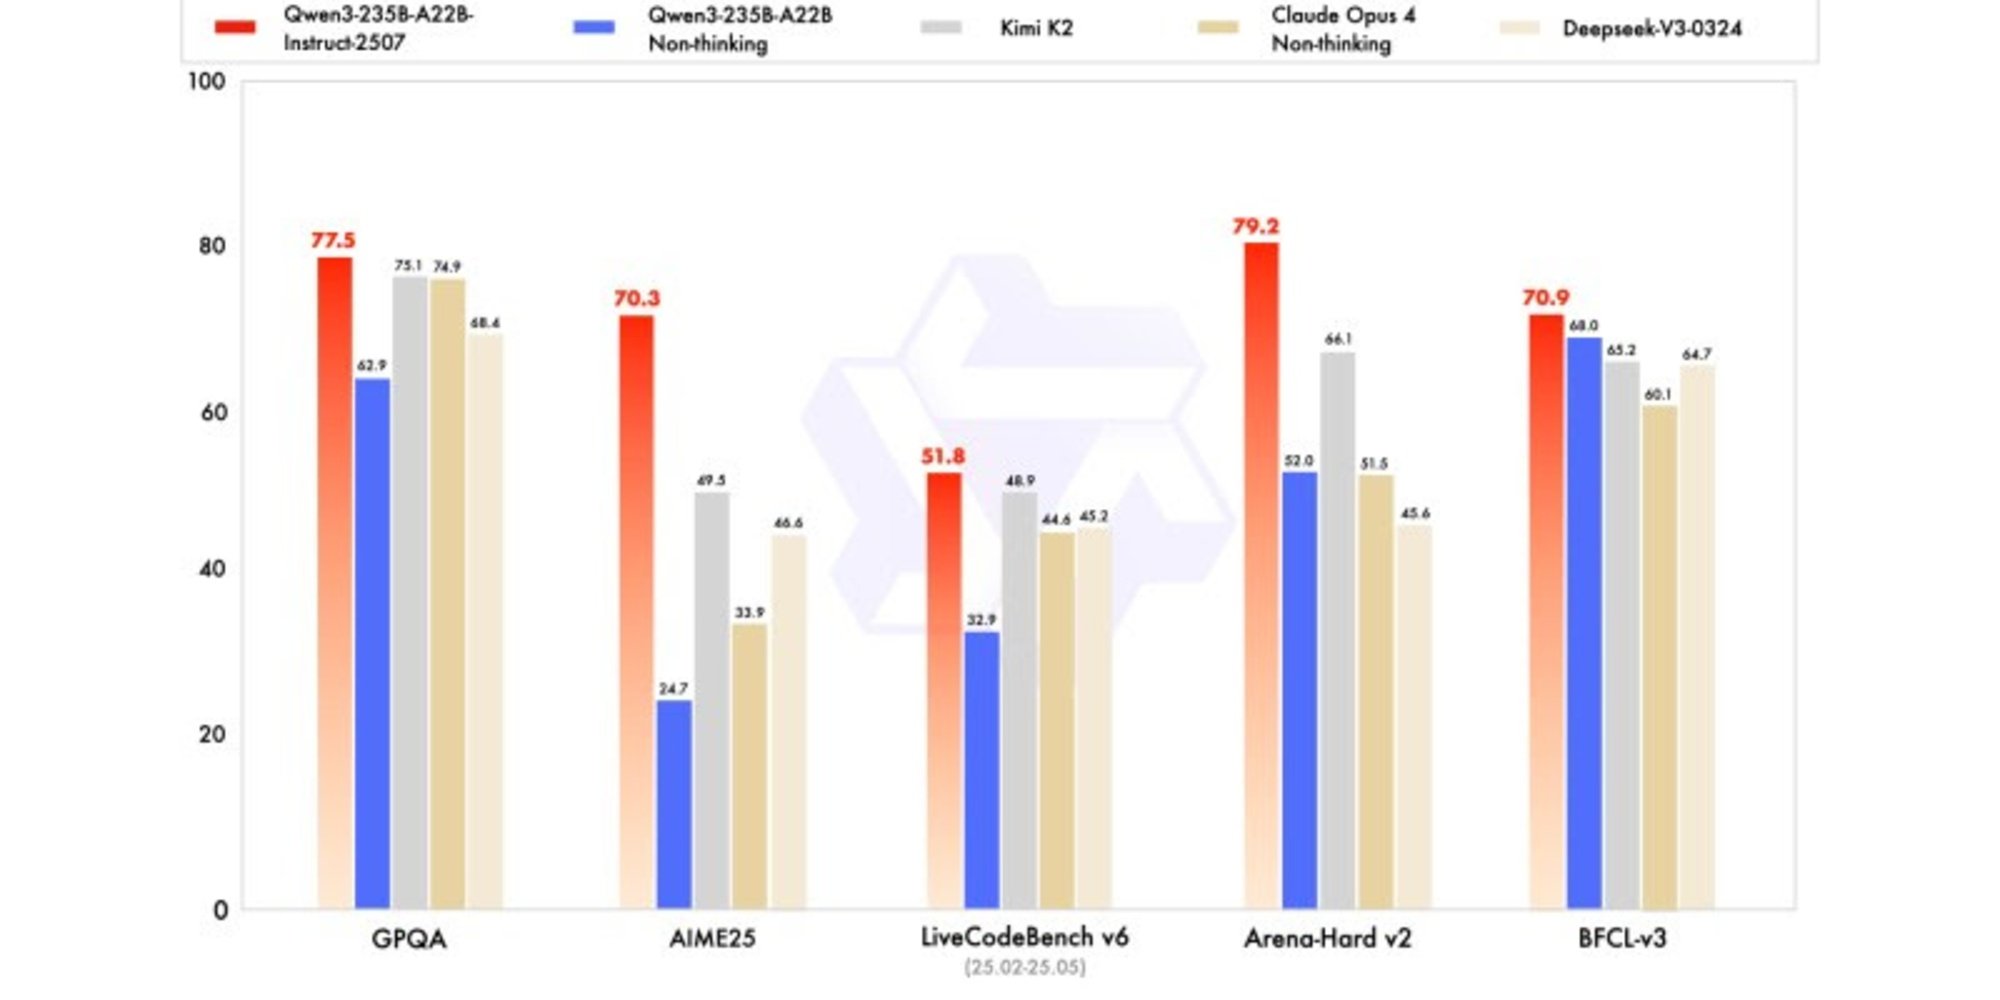
Alibaba lance Qwen3-235B-A22B-Instruct-2507 et rompt avec le raisonnement hybride

23/07
Déploiement en entreprise / organisation

L’Éternaute : Netflix utilise l’IA générative pour la première fois dans une production originale

21/07
Nouveau modèle

Voxtral : Mistral AI entre sur le marché des modèles vocaux open source

18/07
Nouvelle fonctionnalité

OpenAI reporte une nouvelle fois le lancement de son modèle de raisonnement open weight

16/07
Pilote / POC / expérimentation

L'expérimentation de résumés d'articles Wikipedia générés par IA tourne court

17/06
Nouveau modèle

Mistral AI défie DeepSeek avec Magistral, son premier modèle de raisonnement avancé

11/06
Prix / distinction scientifique

Croquette Crew, le vidéoclip de rap 100 % IA du collectif de GenIArt, primé à l'AI Film Awards Cannes 2025

04/06
Nouveau modèle

Chatterbox : une percée open source dans la synthèse vocale

03/06
Mise à jour de modèle

DeepSeek-R1-0528 : la start-up chinoise continue à se mesurer aux géants américains avec une mise à jour de son modèle phare

02/06
Nouveau modèle

Anthropic dévoile Claude 4, ses agents optimisés pour la programmation et les tâches complexes

23/05
Conférence / salon

Google I/O 2025 : L’IA au cœur de l'écosystème technologique

22/05
Faille / vulnérabilité

Une fuite divulguerait l'intégralité de l'invite système de Claude 3.7 Sonnet

13/05
Nouvelle fonctionnalité

Google rend l'intelligence artificielle de NotebookLM disponible en version multilingue

30/04
Nouveau modèle

OpenAI intègre GPT-Image-1 à son API Images

24/04
Dataset / ressource ouverte

IBM et l'ESA dévoilent TerraMind, un modèle d'observation de la Terre open source

23/04
Nouvelle fonctionnalité

Vers une nouvelle ère du storytelling : après Gen-4, Runway lance Gen-4 Turbo

15/04
Nouveau modèle

OpenAI annonce le lancement de GPT-4.1 : accent sur le codage, le suivi des instructions et la gestion étendue du contexte

15/04

À propos de IA générative

De quoi il s'agit

L'IA générative est un ensemble de systèmes informatiques capables de produire du contenu nouveau : textes, images, vidéos, code source, données synthétiques. Entraînés sur des corpus textuels et visuels massifs, ces modèles identifient des motifs et génèrent des réponses pertinentes à des prompts spécifiques. Distincts des systèmes de classification ou de prédiction, les modèles génératifs se déploient comme une couche cognitive transversale, intégrée progressivement dans les logiciels métier (ERP, CRM, suites bureautiques, plateformes industrielles), équipant chaque fonction d'un assistant automatisé.

Enjeux et débats

Quatre enjeux structurants fragmentent le débat public. Le premier concerne la propriété intellectuelle : les modèles sont entraînés sur des contenus créés par des humains (textes, images, code) sans compensation ni consentement explicite des auteurs, soulevant des questions sur la rémunération et les droits d'usage. Le second est la désinformation : la capacité à produire massivement du contenu plausible (images synthétiques, textes, voix artificielles) abaisse drastiquement le coût de la désinformation, complexifiant la vérification des contenus. Le troisième porte sur les biais : les modèles reproduisent et amplifient les inégalités présentes dans leurs données d'entraînement (représentations stéréotypées dans les images, biais de genre en traduction, discrimination dans les systèmes d'aide à la décision). Enfin, la transparence reste fragile : comprendre comment et pourquoi un modèle produit une réponse donnée demeure techniquement difficile, compliquant la responsabilité juridique et la confiance.

Cadre et acteurs

En Europe, l'AI Act, impose un cadre « basé sur le risque ». Les modèles généralistes d'IA (foundation models) sont soumis à des obligations spécifiques : documentation des données d'entraînement, évaluation des capacités systémiques, mesures de prévention des contenus interdits (discours de haine, incitation à la violence). L'application se fait par étapes. En France, la CNIL apporte des précisions sur la transparence et la gestion des données, tandis que la Commission européenne pilote la mise en œuvre. Parallèlement, les pouvoirs publics européens débattent des mesures d'incitation à la souveraineté technologique et de l'encadrement des modèles fondamentaux. Les fournisseurs de modèles doivent désormais justifier leurs pratiques d'entraînement et limiter les risques systémiques.

Ce que suit ActuIA

ActuIA couvre l'évolution du cadre légal (AI Act, règlementations nationales et sectorielles), les débats sur la propriété intellectuelle et les compromis entre innovation et protection, les avancées en matière de robustesse et d'audit des modèles, les expériences pilotes d'IA générative dans les secteurs public et privé, et les controverses portant sur les usages problématiques (deepfakes, discrimination automatisée). Nous suivons aussi les initiatives de transparence, les travaux de standardisation et les initiatives open source alternatives aux modèles propriétaires.

Concepts clés