

Comment exécuter un LLM sur votre PC AMD Ryzen AI ou votre carte graphique Radeon ?
Pour créer votre propre chatbot IA, suivez les instructions ci-dessous : Téléchargez la bonne version de LM Studio et exécutez le fichier :- Pour les processeurs AMD Ryzen : LM Studio-Windows
- Pour les cartes graphiques AMD Radeon RX série 7000 : LM Studio – Aperçu technique ROCm™
- Si vous souhaitez exécuter Mistral 7b, recherchez : « TheBloke/OpenHermes-2.5-Mistral-7B-GGUF » et sélectionnez-le dans les résultats sur la gauche. Ce sera généralement le premier résultat.
- Si vous souhaitez exécuter LLAMA v2 7b, recherchez : « TheBloke/Llama-2-7B-Chat-GGUF » et sélectionnez-le dans les résultats sur la gauche. Ce sera généralement le premier résultat.
- Vous pouvez également expérimenter d’autres modèles ici.
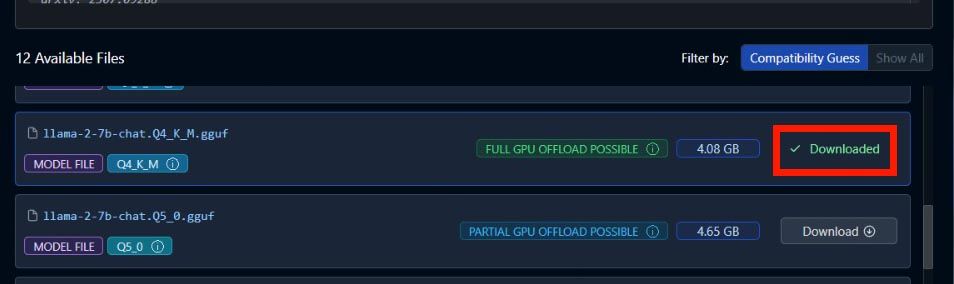
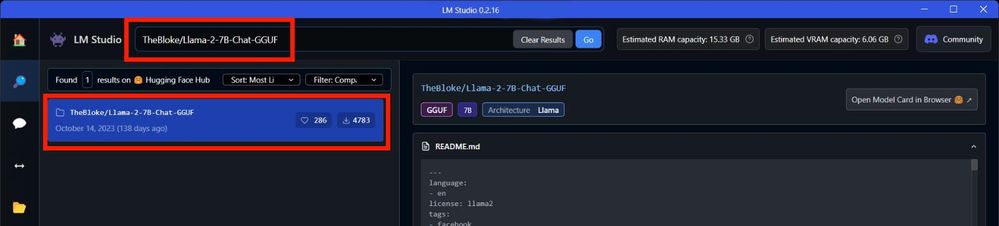 Dans le panneau de droite, faites défiler vers le bas jusqu’à ce que vous voyiez le fichier de modèle Q4 K M. Cliquez sur Télécharger.
AMD recommande Q4 K M pour la plupart des modèles équipés de Ryzen AI. Attendez la fin du téléchargement.
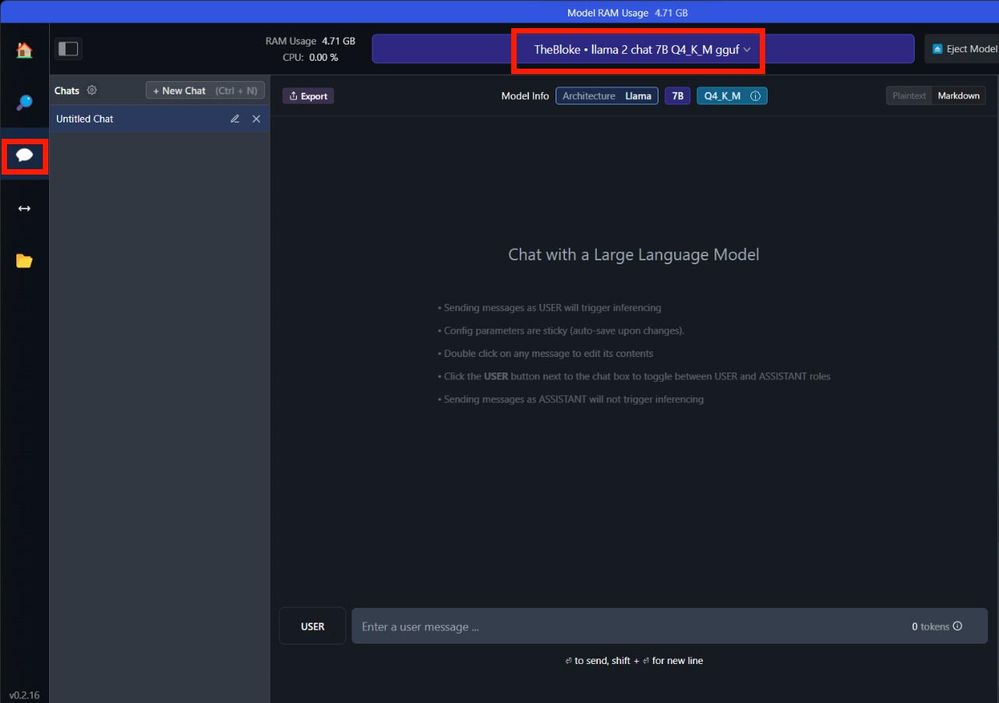
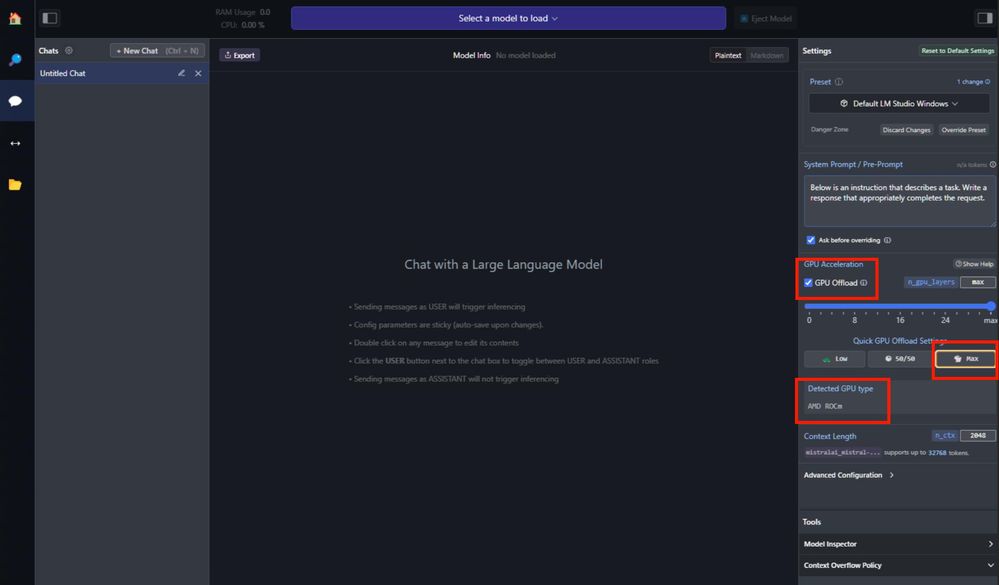
 Allez dans l’onglet chat. Sélectionnez le modèle dans le menu déroulant central en haut au centre et attendez qu’il finisse de se charger.
- Cochez "GPU Offload" sur le panneau latéral droit.
- Déplacez le curseur jusqu’à "Max"
- Assurez-vous qu’AMD ROCm s’affiche comme le type de GPU détecté.
 AMD a comparé les performance de Ryzen AI par rapport au Core Ultra 7 155H. Les tests montrent que Ryzen AI le surpasse dans la génération de contenu, y compris la programmation, avec des vitesses plus rapides sur un chatbot IA LLM.
- Pour les tokens par seconde, Ryzen AI est jusqu'à 17 % plus rapide sur Mistral Instruct et jusqu'à 14 % plus rapide sur LLAMA v2 Chat ;
- En ce qui concerne le temps nécessaire pour obtenir le premier token, Ryzen AI est jusqu'à 41 % plus rapide sur Mistral Instruct et jusqu'à 79 % plus rapide sur LLAMA v2 Chat.

Nos articles remonteront en priorité dans « À la une » de Google.