

L'apport du pseudo-étiquetage
Contrairement aux modèles traditionnels, CoTracker3 exploite ainsi des pseudo-étiquettes générées à partir de vidéos réelles, produites par d’autres modèles préalablement entraînés sur des données synthétiques. Ce processus permet de contourner l’écart statistique entre les données synthétiques et réelles, en utilisant les vidéos réelles comme source d’entraînement, sans nécessiter une annotation humaine laborieuse.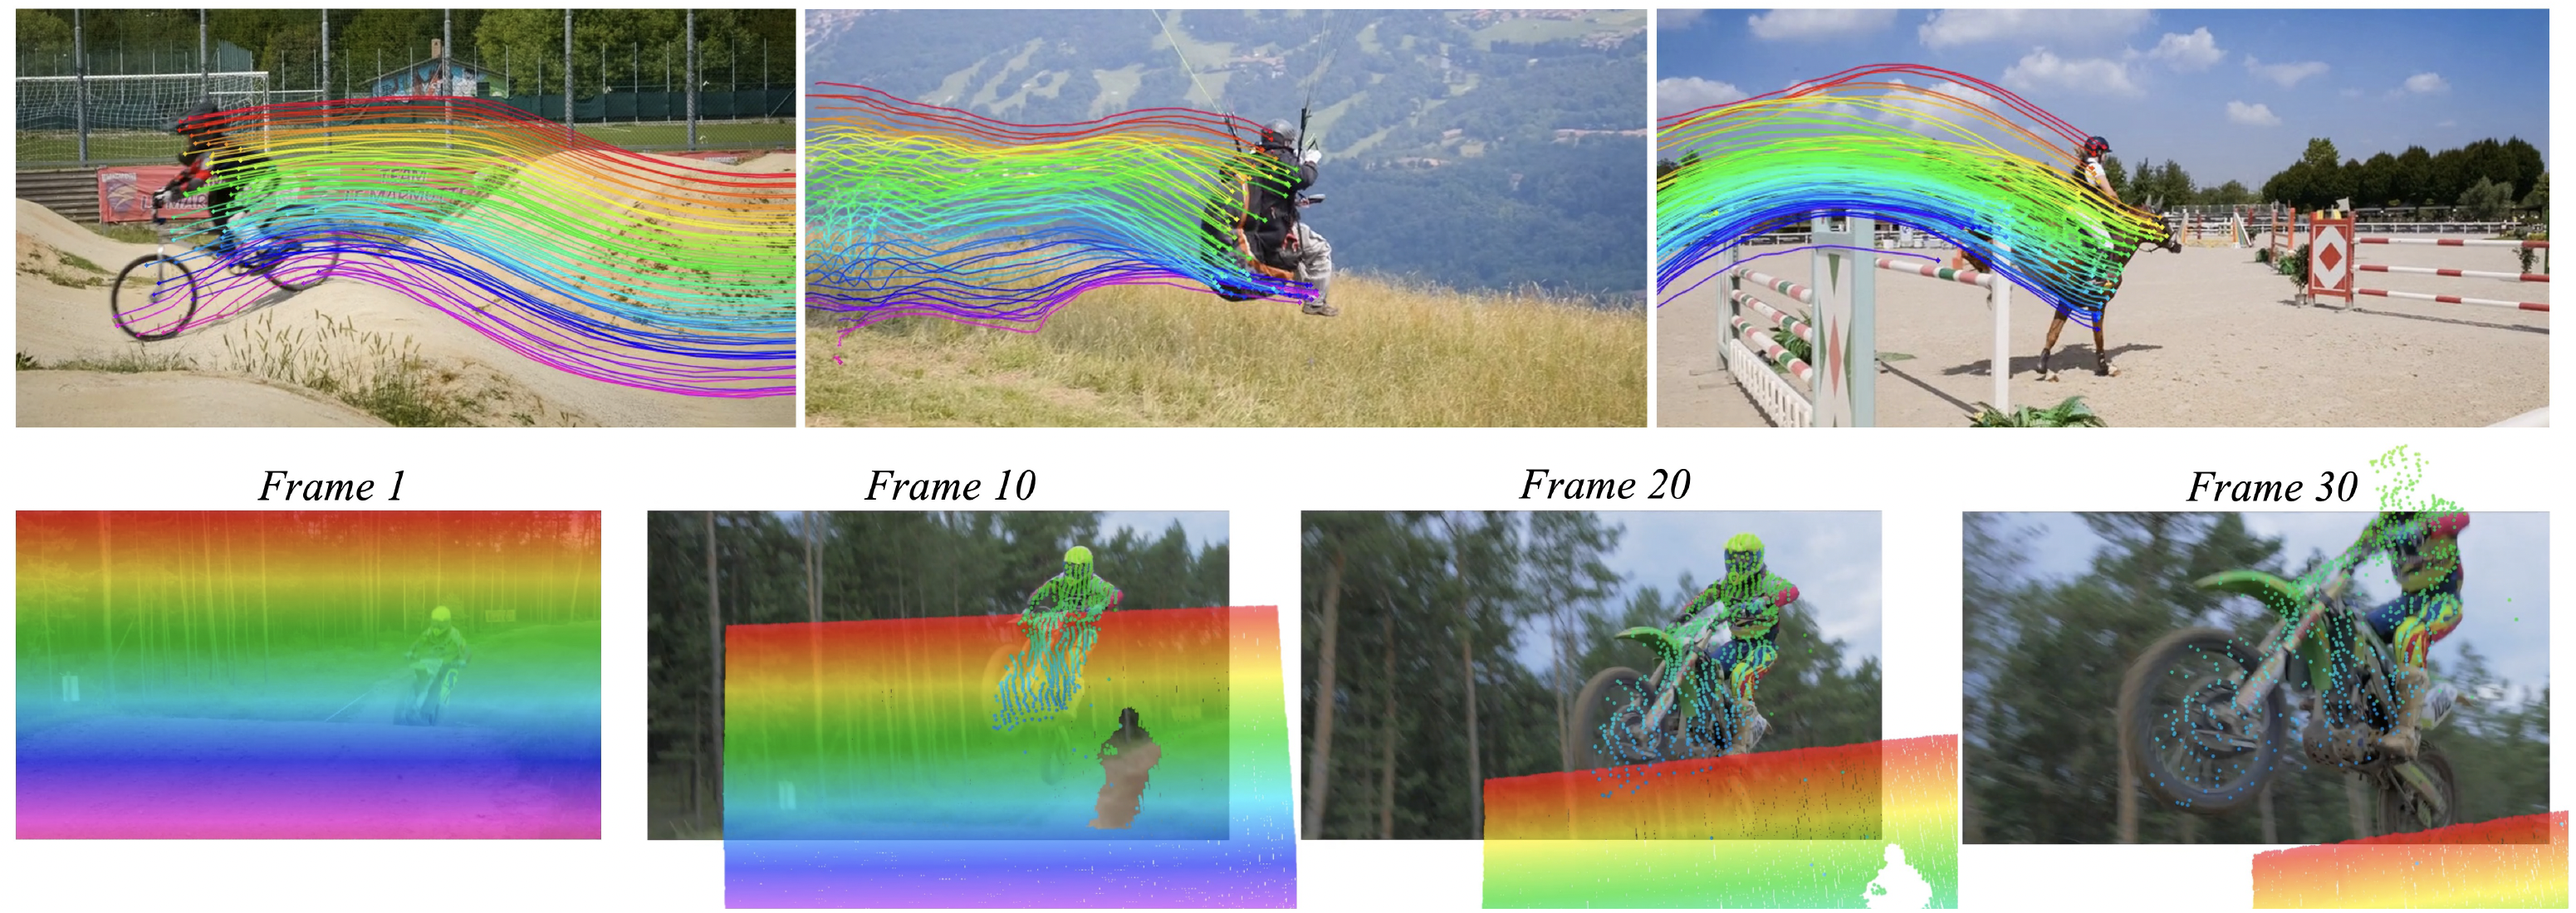
Simplicité et performance accrue
L'une des principales caractéristiques de CoTracker3 est la simplification de son architecture. Il emprunte des éléments aux modèles précédents, y compris les mises à jour itératives et les caractéristiques convolutionnelles de PIPs, l'attention inter-piste pour le suivi conjoint, les pistes virtuelles pour l'efficacité, et l'entraînement déroulé pour une opération par fenêtre de CoTracker, ainsi que la corrélation 4D de LocoTrack. En même temps, il simplifie considérablement certains de ces composants et en élimine d'autres, comme l'étape de correspondance globale de BootsTAPIR et LocoTrack. En réduisant le nombre de composants souvent complexes dans les modèles concurrents, il parvient à offrir une performance accrue tout en nécessitant beaucoup moins de données d’entraînement. Ce modèle est capable de suivre des points avec une précision améliorée, même lorsqu’ils sont temporairement occlus ou sortent du champ de vision.Mise à l'échelle et résultats
CoTracker3 se distingue également par sa capacité à bénéficier d'une mise à l’échelle, aussi bien en mode en ligne qu’hors ligne. Son efficacité dans le suivi de points, même sur des périodes prolongées et dans des conditions difficiles, en fait une solution performante sur des benchmarks standards. Bien que certains cas spécifiques, comme le suivi sur des surfaces sans caractéristiques distinctes (par exemple, un ciel dégagé), restent des défis, le modèle surpasse globalement ses prédécesseurs tels que LocoTrack et BootsTAPIR. Pour les chercheurs, il démontre la puissance d’un protocole d’entraînement semi-supervisé simple, où des vidéos réelles sont annotées en utilisant plusieurs modèles de suivi disponibles sur le marché, puis utilisées pour affiner un modèle qui surpasse tous les enseignants. Cette approche lui permet de surpasser les modèles entraînés sur 1 000 fois plus de vidéos. En suivant les points conjointement, CoTracker3 gère les occlusions mieux que tout autre modèle, particulièrement en mode hors ligne, comme on peut le voir dans la vidéo ci-dessous. [embed]https://cotracker3.github.io/videos/teaser2/bmx_bumps_ours_offline.mp4[/embed] Il pourrait, selon eux, servir de bloc de construction pour des tâches nécessitant une estimation de mouvement, telles que le suivi 3D, la génération de vidéos contrôlées ou la reconstruction 3D dynamique. Retrouver son référentiel GitHub ici, la démo sur Hugging Face ici. CoTracker3 et les ressources associées sont mis à disposition sous une licence A-NC afin de faciliter la poursuite des recherches. Références de l'article : "COTRACKER3: SIMPLER AND BETTER POINT TRACKING BY PSEUDO-LABELLING REAL VIDEOS"arXiv:2410.11831v1 [cs.CV] 15 Oct 2024 Auteurs et affiliations : Nikita Karaev1,2,Iurii Makarov1,Jianyuan Wang1,2,Natalia Neverova1,Andrea Vedaldi1,Christian Rupprecht2 1 Meta AI, 2Groupe de géométrie visuelle, Université d’Oxford
Nos articles remonteront en priorité dans « À la une » de Google.