

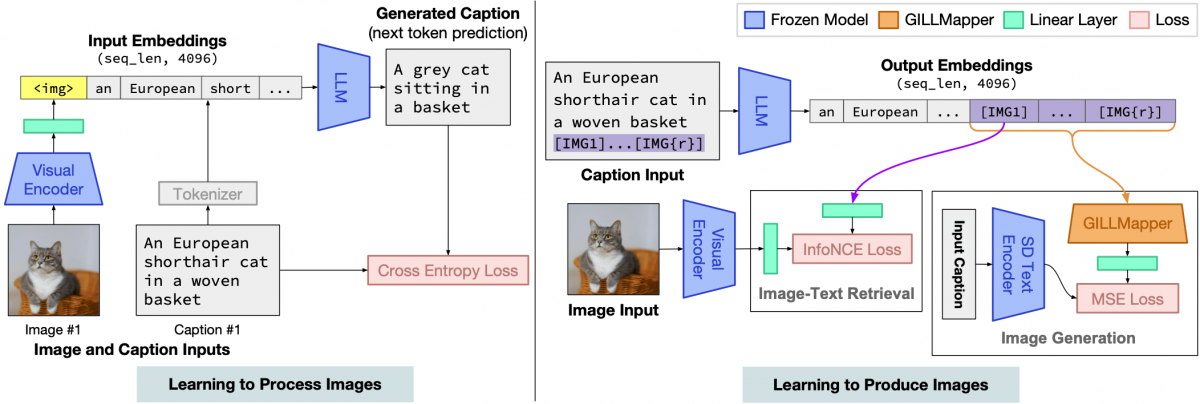
 Aperçu de l’architecture du modèle GILL. Il est entraîné avec une perte de légende pour apprendre à traiter les images (à gauche), et avec des pertes pour la récupération d’image et la génération d’image pour apprendre à produire des images (à droite).[/caption]
Les chercheurs ont entraîné l’encodeur d’image ViT-L, dérivé de CLIP, à aligner ses embeddings avec ceux générés par le modèle texte-vers-image, et ce dernier à identifier les requêtes demandant une image, permettant ainsi au système de produire ou de récupérer des images.
Ils ont également construit un classificateur linéaire pour permettre au modèle GILL de déterminer quand une image devrait être récupérée ou générée. Pour l'entraîner, ils ont collecté des annotations humaines sur PartiPrompts P2, une collection de 1632 invites utilisée pour évaluer les modèles de génération d’images. Pour chacune d’entre elles, ils ont généré une image et récupéré l’image la plus similaire de CC3M, un ensemble de données composé de ~3,3 millions d’images annotées avec des légendes.
Cinq annotateurs humains ont ensuite sélectionné parmi ces 2 images, celle qui correspondait le mieux à l’invite.
[caption id="attachment_54912" align="alignnone" width="696"]
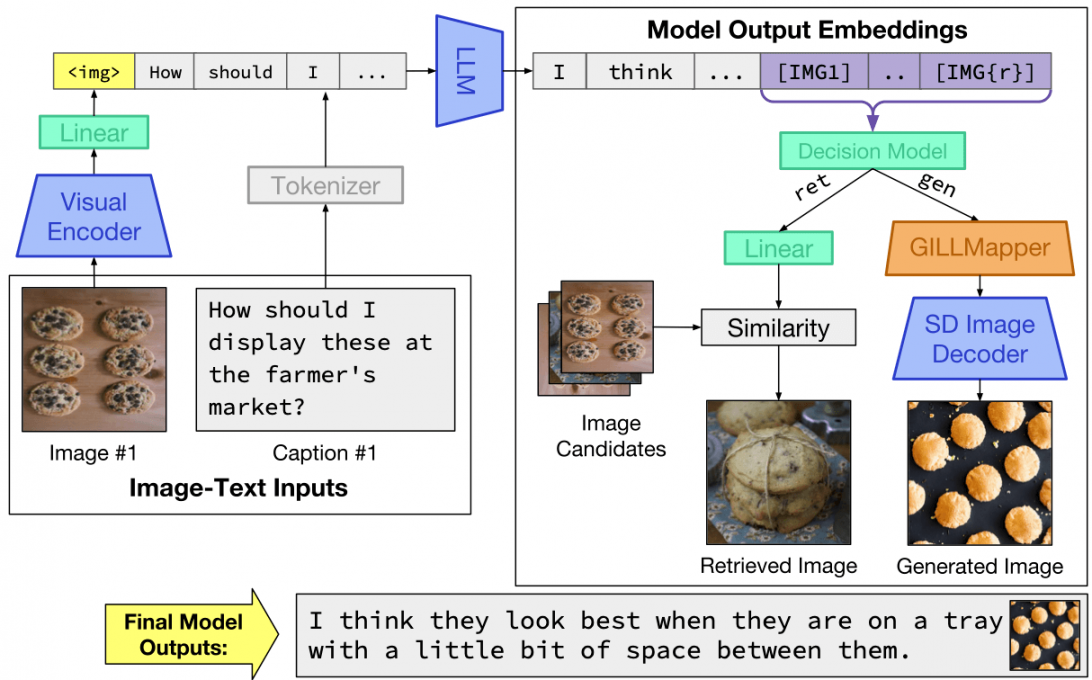 Lors de l’inférence, le modèle prend en compte les entrées d’image et de texte entrelacées arbitrairement et produit du texte entrelacé avec des plongements d’image. Après avoir décidé de récupérer ou de générer pour un ensemble particulier de jetons, il renvoie les sorties d’image appropriées (récupérées ou générées).[/caption]
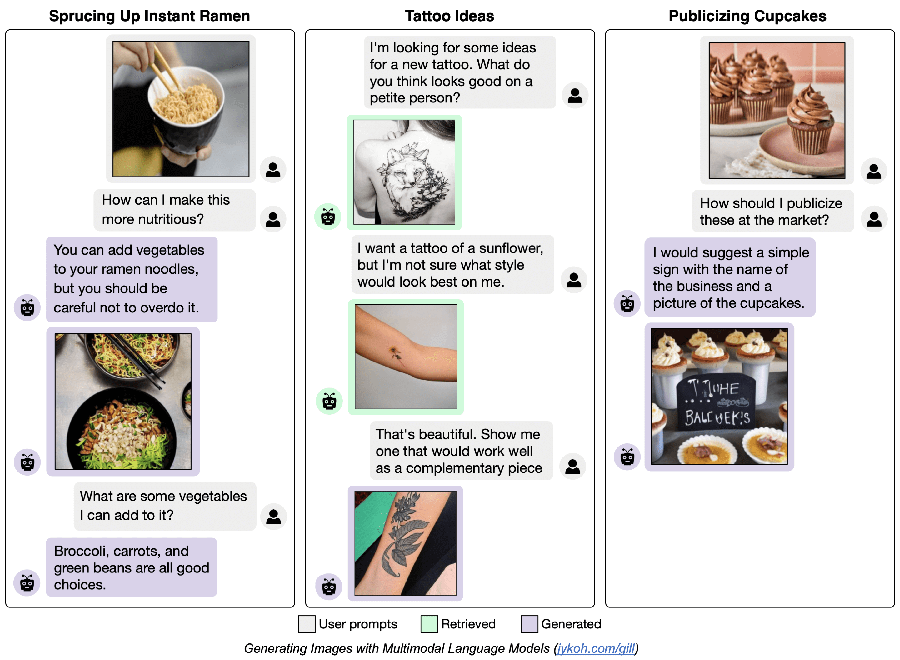
GILL peut être invité à générer du texte de type dialogue, comme ci-dessous :
Limitations
Les chercheurs soulignent que malgré ses capacités intéressantes, GILL est un prototype de recherche précoce et présente plusieurs limites, notamment celles des LLM. Ils concluent toutefois :"Notre approche est modulaire et peut bénéficier de modèles de langage multimodaux ou visuels plus puissants qui seront publiés à l'avenir. L'extension de la dorsale du modèle de langage multimodal, de la dorsale de génération d'images ou du modèle de traitement visuel constitue des orientations prometteuses qui devraient probablement renforcer davantage les capacités vision-langage".
Références de l'article : Generating Images with Large Language Models class="arxivid">arXiv :2305.17216v3 Auteurs : Jing Yu Koh, Daniel Fried, Ruslan Salakhutdinov, Université Carnegie Mellon
Nos articles remonteront en priorité dans « À la une » de Google.