

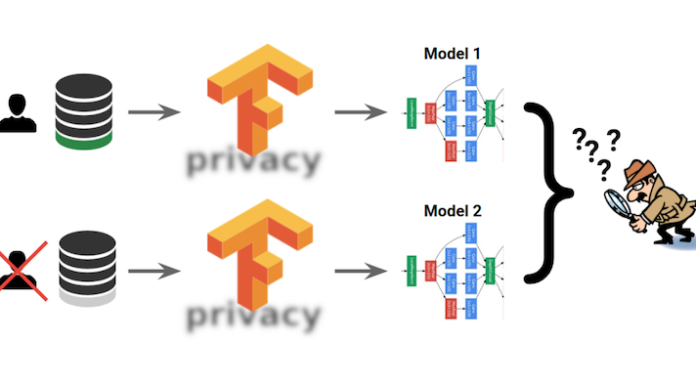
"Idéalement, les paramètres des modèles de machine learning formés devraient coder des modèles généraux plutôt que des faits concernant des exemples de formation spécifiques. Pour ce faire et pour donner de fortes garanties de confidentialité lorsque les données de formation sont sensibles, il est possible d'utiliser des techniques basées sur la théorie de la confidentialité différentielle. lors de la formation sur les données des utilisateurs, ces techniques notamment offrent de solides garanties mathématiques que les modèles n’apprennent ni ne se souviennent des détails d’un utilisateur spécifique. En particulier pour le deep learning, les garanties supplémentaires peuvent renforcer utilement les protections offertes par d'autres techniques de protection de la vie privée, qu'elles soient établies, telles que le seuillage et la suppression de données, ou nouvelles, telles que TensorFlow Federated learning."Basé sur la technique de Differential Privacy ou « confidentialité différentielle », ce module a pour objectif de protéger les données personnelles. Désormais disponible en open source sur Git Hub, il permet d'empêcher les systèmes IA en phase d'apprentissage de récupérer et d'encoder les informations des personnes et donc de pouvoir les identifier.
La nécessité d'anonymiser les données pour le développement d'intelligences artificielles est centrale. TensorFlow Privacy semble donc répondre à ce défi puisqu'il élimine les éléments pouvant permettre d'identifier un utilisateur. Cependant, les observateurs indiquent qu'il y a un risque de suppression dans le même temps de données pertinentes pour l'apprentissage d'un système et qu'il ne permet pas d'apprendre d'un événement s'étant produit une seule fois. Google appelle de son côté les utilisateurs à étudier les exemples et tutoriels (tâche MNIST, TensorFlow 2.0, Keras...) fournis sur GitHub :"Pour utiliser TensorFlow Privacy, aucune expertise en matière de confidentialité ni en mathématiques sous-jacentes ne devrait être requise : les personnes utilisant des mécanismes TensorFlow standard ne devraient pas avoir à modifier leurs architectures, procédures ou processus de modèle. Au lieu de cela, pour former des modèles qui protègent la confidentialité de leurs données de formation, il vous suffit souvent d’apporter quelques modifications simples au code et de régler les hyperparamètres pertinents pour la confidentialité."
"Nous souhaitons que TensorFlow Privacy devienne une plaque tournante des meilleures techniques pour la formation de modèles d’apprentissage automatique avec de fortes garanties de confidentialité. Par conséquent, nous encourageons toutes les parties intéressées à participer."

Nos articles remonteront en priorité dans « À la une » de Google.