Ferret, un LLM multimodal open source
Ferret, entraîné à l’aide de 8 GPU Nvidia A100, se démarque d'autres modèles multimodaux existants en excellant dans les tâches de référence et de mise à la terre. Il n'analyse pas une image dans son ensemble, mais des régions spécifiques soumises par un utilisateur, qu'elles se réfèrent à des objets ou à des textes, que ce soit sous forme de point, de boîte ou autre forme libre et les incorpore aux requêtes.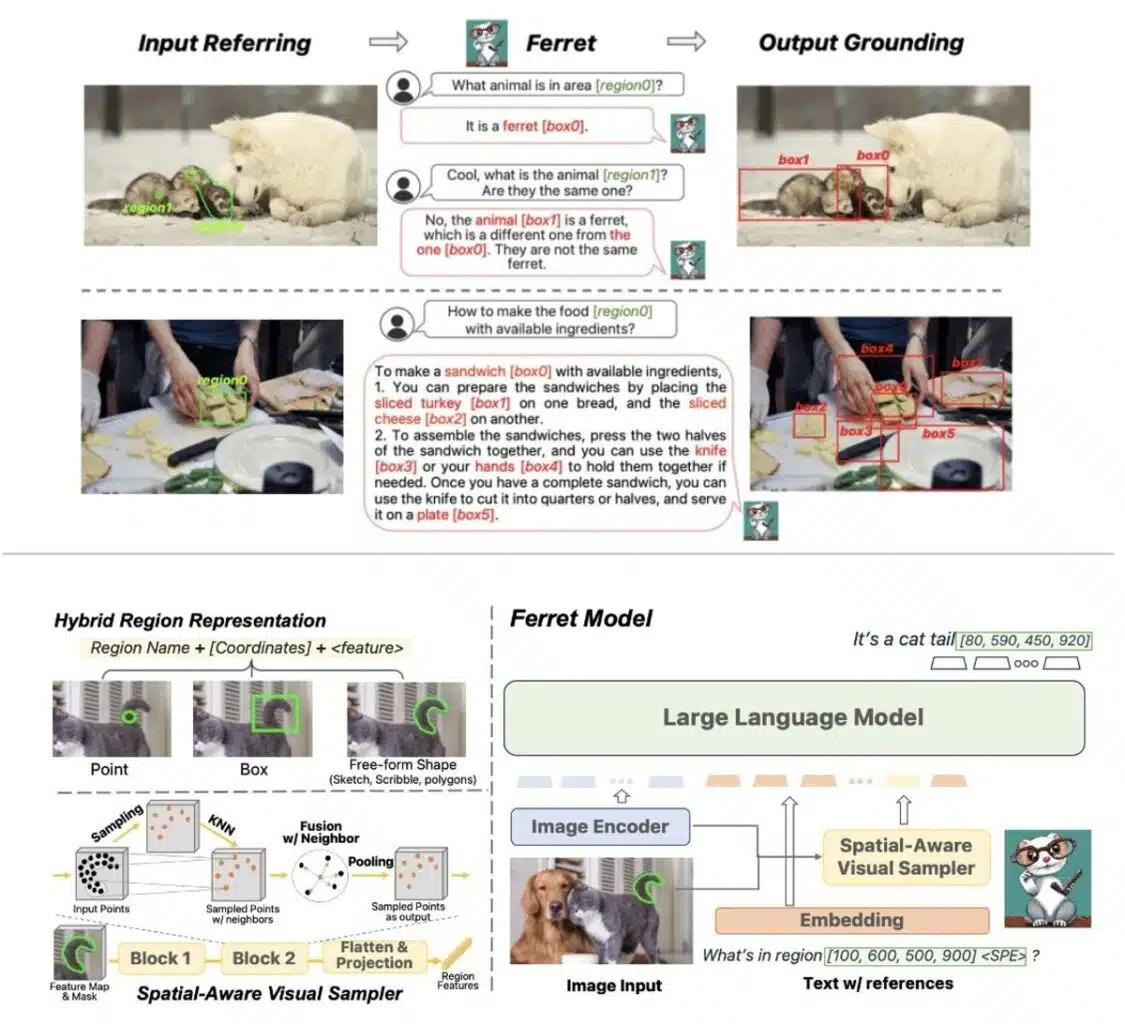 Comme représenté dans la figure ci-dessus, Ferret se compose d'un encodeur d'image pour extraire des embeddings d'image, d'un échantillonneur visuel conscient de l'espace proposé pour extraire des caractéristiques continues régionales, et d'un MLLM pour modéliser conjointement les caractéristiques de l'image, du texte et de la région.
Un entraînement sur GRIT
Pour entraîner leur modèle, les chercheurs ont créé GRIT (Ground-and-Refer Instruction-Tuning) un ensemble de données d'ajustement d'instructions pour la référence et l'ancrage multimodal, comprenant 1,1 million d'échantillons. GRIT couvre divers niveaux de connaissances spatiales, incluant des objets, des relations, des descriptions de régions et des raisonnements complexes. L'ensemble de données provient principalement de tâches vision-langage existantes, adaptées avec des modèles soigneusement conçus pour suivre les instructions. De plus, 34 000 conversations d'ajustement d'instructions ont été collectées avec l'aide de ChatGPT/GPT-4 pour faciliter l'entraînement d'un généraliste de référence et d'ancrage ouvert au vocabulaire et orienté vers l'instruction. Enfin, une extraction consciente de données négatives spatiales a été réalisée pour renforcer la robustesse du modèle.Les performances du modèle
Les chercheurs ont comparé les performances de Ferret à celles de GPT-4V, le LLM multimodal d'OpenAI qui a élargi les capacités de GPT-4 à la compréhension des images. Ils ont ainsi pu constaté que GPT-4V a une compréhension limitée lorsqu'il s'agit de référencer des petites régions dans une image, tandis que Ferret excelle dans la précision de cette tâche. Bien que GPT-4V démontre une connaissance approfondie du bon sens, Ferret se distingue par sa capacité à fournir des boîtes englobantes précises, en particulier pour des applications nécessitant une grande précision dans des régions plus petites. Ferret excelle également dans l'ancrage, comme illustré par des tests avec des CAPTCHAs, démontrant une identification précise des feux de circulation même dans des scénarios complexes. Dans l'ensemble, GPT-4V excelle dans la réponse à des questions générales, tandis que Ferret se démarque dans des situations nécessitant une précision spatiale et une compréhension détaillée des régions spécifiques de l'image. Les chercheurs soulignent que Ferret, comme la plupart des MLLMs, peut produire des réponses nocives et contrefactuelles. Ils prévoient d'améliorer leur modèle afin de pouvoir générer des masques de segmentation en plus des boîtes englobantes. Ferret offre une base solide pour les futures avancées de l'IA conversationnelle d'Apple, notamment dans la recherche visuelle et d'autres applications nécessitant une compréhension contextuelle nuancée. Références de l'article : "Ferret : refer and ground anything anywhere at any granularity" arXiv:2310.07704v1 Auteurs : Haoxuan You1 , Haotian Zhang2, Zhe Gan2, Xianzhi Du2, Bowen Zhang2, Zirui Wang2, Liangliang Cao2, Shih-Fu Chang1, Yinfei Yang2. Affiliations : 1Columbia University, 2Apple AI/ML
Nos articles remonteront en priorité dans « À la une » de Google.