

Les trois tailles et trois versions du modèle
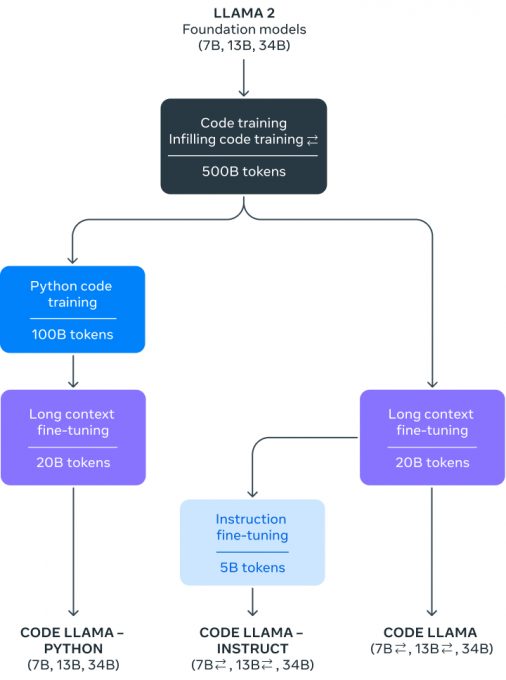
Code Llama est disponible en trois tailles: 7, 13 et 34 milliards de paramètres. Chaque modèle de fondation a été entraîné sur 500 milliards de jetons de code et de données liées au code. Les modèles 7B et 13B ont également été formés avec la capacité de remplissage au milieu (FIM), ce qui leur permet d'insérer du code dans un code existant. Meta propose également deux versions affinées du modèle Code Llama :- Code Llama - Python, affinée spécifiquement sur 100 milliards de jetons de code Python, pour le langage Python, le plus utilisé pour générer du code ;
- Code Llama - Instruct, une itération spécialisée et calibrée de Code Llama. Le modèle a été affiné en utilisant des exemples de prompts de langage naturel et les réponses attendues. Cette approche vise à améliorer la compréhension du modèle des attentes humaines exprimées dans les instructions. Grâce à cette approche, il est en mesure de générer des réponses plus pertinentes et sécurisées en langage naturel et Meta recommande aux développeurs d'utiliser cette variante.
L'évaluation des performances de CodeLlama
Pour tester les performances de Code Llama par rapport aux solutions existantes, Meta a utilisé deux benchmarks populaires de programmation : HumanEval et Mostly Basic Python Programming (MBPP). HumanEval évalue la capacité du modèle à compléter du code en se basant sur des docstrings, tandis que MBPP évalue la capacité du modèle à écrire du code en se basant sur une description. [caption id="attachment_51851" align="aligncenter" width="557"]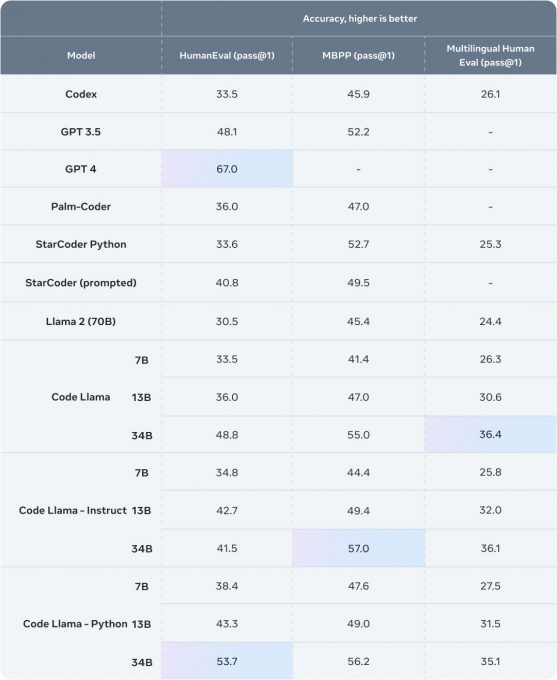 Crédit Meta AI[/caption]
Code Llama, bien que moins performant que GPT-4 sur le benchmark HumanEval, a obtenu de meilleurs résultats que les LLM open source spécifiques au code, et a surpassé Llama 2. Par exemple, Code Llama 34B a obtenu un score de 53,7 % sur HumanEval et de 56,2 % sur MBPP, le score le plus élevé parmi d'autres solutions ouvertes de pointe.
Pour télécharger les poids de modèle et les tokenizers, il faut accéder au site Web de Meta AI et accepter sa licence. On peut trouver le code d’inférence pour les modèles Code Llama sur GitHub.
Sources de cet article :"Introducing Code Llama, a state-of-the-art large language model for coding", publié sur le blog IA de Meta.

Nos articles remonteront en priorité dans « À la une » de Google.