

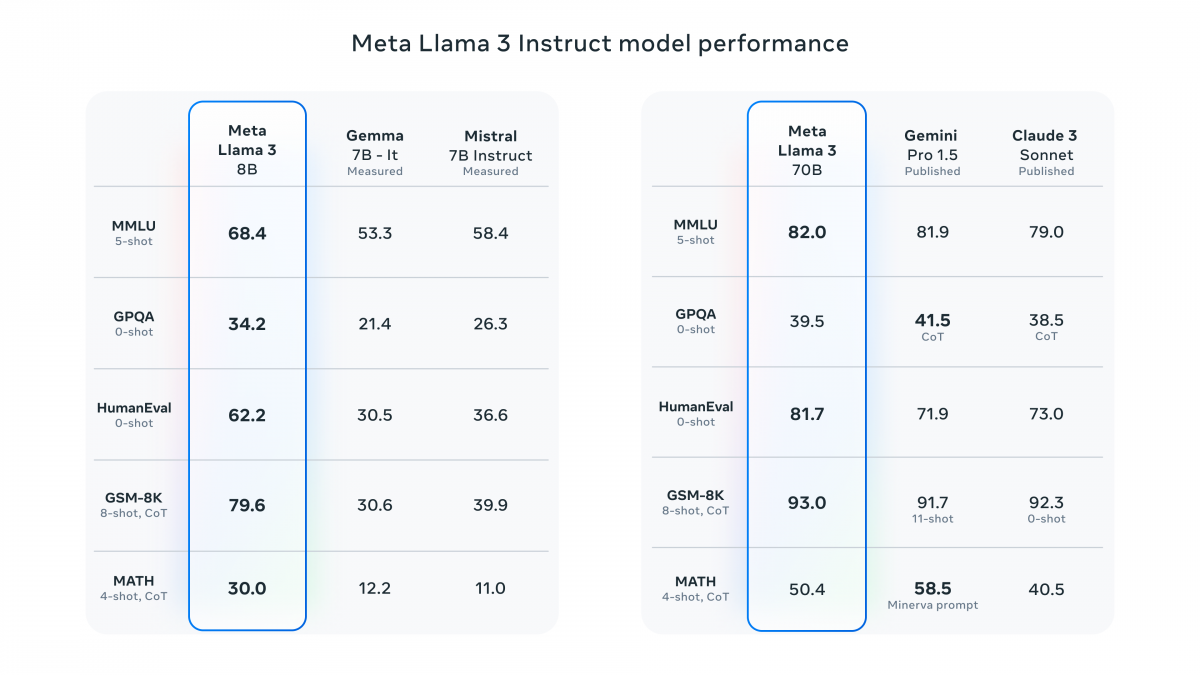
 L'ensemble de données de pré-entrainement de Llama 3 totalise plus de 15 téraoctets de jetons de données publiques, soit 7 fois plus que celui de Llama 2 et comprend quatre fois plus de code. Pour anticiper les futurs cas d'utilisation multilingues, plus de 5 % de ces données ne sont pas anglaises, couvrant plus de 30 langues. Même si elles sont de haute qualité, Meta reconnaît que les performances dans ces langues peuvent varier par rapport à l'anglais.
Des améliorations ont également été apportées au niveau architecture. Llama 3 utilise un tokenizer avec un vocabulaire de 128 000 jetons qui encode le langage beaucoup plus efficacement. Pour optimiser le processus d'inférence des modèles Llama 3, l’approche d’attention des requêtes groupées (Group Query Attention ou GQA) a été mise en œuvre pour les versions de 8B et 70B. Les modèles ont été entraînés sur des séquences de 8192 tokens, avec l’application d’un masque spécifique assurant que l’attention accordée reste confinée aux frontières du document.
Les deux modèles seront bientôt disponibles sur AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM et Snowflake.
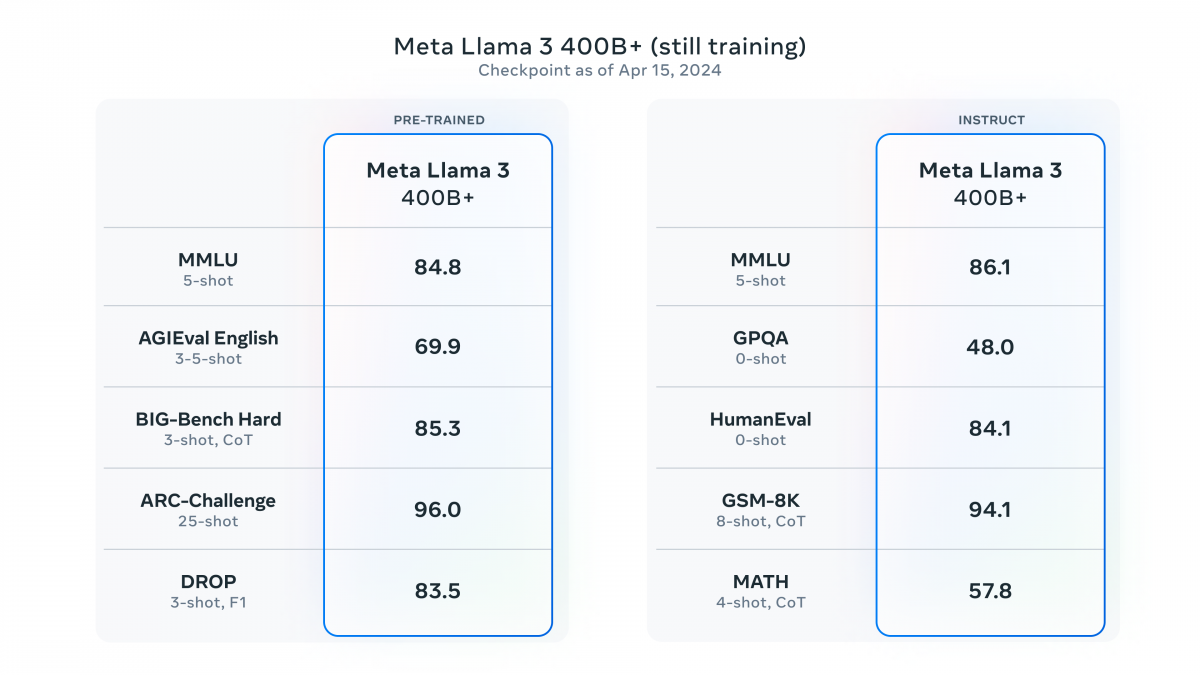
Meta annonce pour les prochains mois plusieurs modèles multimodaux, avec une prise en charge de plusieurs langues, une fenêtre contextuelle plus longue, ainsi que des capacités globales plus robustes. Il donne un aperçu de Llama 3 400B, le plus grand modèle de la famille dont il poursuit l'entraînement.
 Les poids de Llama 3 et le générateur de jetons sont téléchargeables sur GitHub.

Nos articles remonteront en priorité dans « À la une » de Google.