

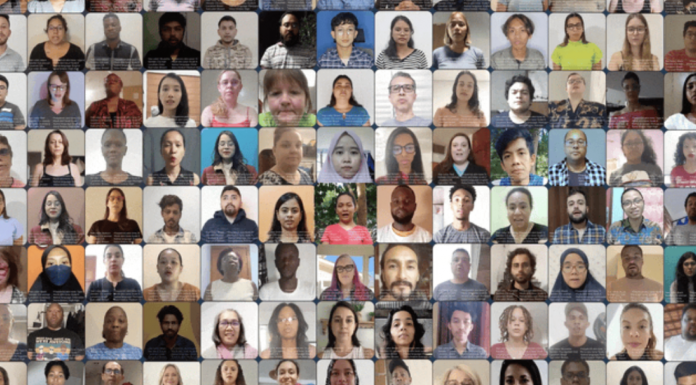
Casual conversations V2, un dataset multilingue
Meta a voulu approfondir les sous-catégories afin d’identifier les lacunes potentielles de son modèle en matière d’équité et de robustesse. La société a continué à collaborer avec des experts pour élargir l’ensemble de données, afin d’aider le milieu de la recherche à évaluer les préoccupations en matière d’équité et de robustesse des modèles d'IA, plus particulièrement pour la vision par ordinateur et le traitement du langage naturel, sur des données réalistes et diversifiées. Cette 2ème version du modèle que Meta vient de rendre accessible au public, également basée sur le consentement, compte ainsi 11 catégories. L'ensemble de données comprend 26 467 monologues vidéo enregistrés dans sept pays (Brésil, Inde, Indonésie, Mexique, Vietnam, Philippines et États-Unis). Les 5 567 participants ont, comme pour la première version, été rétribués et ont eux-aussi fourni des attributs auto-identifiés : âge, sexe, langue/dialecte, géolocalisation, handicap, ornements physiques, attributs physiques. Un groupe d’annotateurs formés a étiqueté le teint apparent des participants à l’aide de l’échelle de Fitzpatrick et de l’échelle Monk, annoté le timbre de la voix, l’activité et les configurations d’enregistrement. Meta espère étendre davantage l'ensemble de données à d'autres zones géographiques par le futur. Roy Austin, Vice-Président, avocat général adjoint pour les droits civils chez Meta, assure : « Pour accroître la non-discrimination, l’équité et la sécurité dans l’IA, il est important de disposer de données inclusives et de diversité au sein des catégories de données afin que les chercheurs puissent mieux évaluer dans quelle mesure un modèle spécifique ou un produit alimenté par l’IA fonctionne pour différents groupes démographiques. Cet ensemble de données joue un rôle important pour s’assurer que la technologie que nous construisons a l’équité à l’esprit pour tous dès le départ".
Nos articles remonteront en priorité dans « À la une » de Google.