초기 투자자 중 한 명은 인공지능을 보다 신중하게 만들기를 원했다. Anthropic 창립 2년 후, 그는 자신의 투자 전략이 실패했다고 판단했다. 그럼에도 Claude 뒤에는 창업자들의 신념이 채용, 거버넌스, 제품을 형성했다. 그러나 임무가 성장의 요구와 맞닿았을 때 누가 결정을 강제할 수 있는가?
2023년 4월, Jaan Tallinn은 실망할 만한 분명한 이유가 있었다. Skype 공동창업자는 Anthropic을 포함한 인공지능 연구소들에 자금을 대며 그들이 보다 신중하게 행동하도록 영향을 미치길 바랐다. 그러나 해당 기업은 가장 강력한 시스템들의 훈련을 6개월간 중단하자는 호소에 서명하지 않았다. 이 이니셔티브는 그가 공동창립한 Future of Life Institute 등에서 비롯된 것이었다.
그는 Semafor와의 인터뷰에서 “Plan A failed”라고 털어놓았다. Plan A는 실패했다. Anthropic 측은 원칙적으로 청원서에 서명하지는 않는다고 답했다. 그럼에도 Tallinn은 그들을 자신이 아는 다른 연구소들보다 안전에 더 신경 쓰는 편이라고 평가했다. 2023년 4월 28일 보도에 담긴 이 불일치는 몇 줄로 정리할 수 있다: 우려를 공유하고, 그 우려를 진지하게 받아들이는 이들을 자금 지원하고, 실제 결정을 얻는 것은 서로 다른 일이라는 것이다.
이러한 난관은 Anthropic의 역사 전반을 관통한다. 회사는 안전 우려를 연구의 한 축으로 자리매김했고, 이어 거버넌스 규칙에도 반영했다. 또한 채용을 하고 자금을 조달했으며 산업적 약속을 통해 스스로가 덜 위험하도록 만들고자 했던 경쟁의 한가운데에 섰다. 그들의 선택을 이해하려면 신념이 책임으로 전환되는 순간의 사람들을 따라가야 한다.
OpenAI 이후, 하나의 내기에 따라 조직을 세우다
이 이야기는 다른 조직에서 시작된다. 2015년 12월, Sam Altman과 Elon Musk는 OpenAI를 비영리 연구기관으로 소개한다. 인공지능의 집단적 이익은 이미 창립 선언문(Internet Archive에 보존)의 핵심이었다. 이 야망은 Anthropic과 두 회사 간의 경쟁보다 앞선다. Amodei 형제는 OpenAI에서 일하다가 2021년 초에 자신들만의 연구소를 창업하기 위해 떠났다.
Dario의 신중함은 이미 구체적인 제한으로 드러난 바 있다. 2019년 2월 14일, OpenAI에서 그는 GPT-2의 가장 강력한 버전을 즉시 공개하지 않기로 정당화하는 발표문에 공동 서명했다. 악용 위험을 이유로 축소된 버전이 배포되었고, 완전한 모델은 단계적 공개 후 그해 11월 5일에 접근 가능해졌다. Dario는 Anthropic을 공동창립하기 거의 2년 전부터 공개를 제한하는 집단적 결정을 공개적으로 지지해온 셈이다. 모델을 개발하고 위험을 평가하며 누가 접근할 수 있는지를 결정하는 일은 이미 동일한 판단의 일부였다.
일곱 창업자는 팬데믹 상황 속에서 모여야 했다. 그들은 야외, 때로는 정원에서 마스크를 쓰고 거리두기를 하며 만났다. Daniela Amodei는 이러한 초창기를 Future of Life Institute와의 인터뷰(2022년 3월)에 회고한다. 그룹은 이미 서로를 알고 있었고, 하나의 조직 안에서 모델의 능력 연구와 그 안전성 연구를 함께 모으길 원했다.
Dario는 그 분리를 이렇게 설명한다: 그들의 내기는 이전에는 더 큰 구조 안에 존재했으나, 이제는 모든 전략적 결정을 그 내기 주위에 둘 수 있는 회사를 원했다는 것이다. 창업자들의 회고에서 2021년의 결별은 공통의 방향을 택하고 조직 전체를 그것에 바칠 수 있는 가능성에 기인한다.
남매는 서로 다른 역량을 가져왔다. CEO인 Dario는 물리학과 신경과학 배경을 가졌다. 회장인 Daniela는 문학을 전공하고 정치 부전공을 한 UC Santa Cruz 출신이다. 2022년 인터뷰에서 그녀는 워싱턴의 NGO와 정치 분야에서의 경력도 회고한다. 그들의 도덕적 질문은 Claude와 함께 시작된 것이 아니다: 2003년 Caltech 학생신문은 이미 Dario의 이라크전 반대 활동과 과학자의 책임에 대한 우려를 전하고 있다.
이런 근접성은 아주 평범한 효과를 낳는다. 2023년 7월 물리학자 수를 묻는 질문에 Daniela는 그들의 네트워크 중요성을 인정한다. 그룹을 성장시키려면 회의를 열고, 채용하고, 판단을 내려야 한다. 그녀는 하루 초반 몇 시간을 성찰에 남기고 신입 직원을 만나려 애썼다고 회고하는데, 조직이 커지면서 이는 더 어려워졌다고 한다. Stripe(Anthropic의 상업적 파트너)가 게재한 인터뷰에서 이 사명은 인원이 늘어날 때 공동 문화를 유지하려는 경영자의 노력으로도 드러난다.
자선 활동은 어떻게 연구소에 스며드는가
이 그룹을 회사로 전환하려면 자금이 필요하다. 2021년 5월 발표된 초기 라운드는 1억 2,400만 달러를 가져왔다. Jaan Tallinn이 이를 주도했고 Dustin Moskovitz(페이스북 공동창업자)도 투자자 명단에 포함되었다. 그들의 이름은 자금 조달 발표문에 기재되어 있다.
이 업계 일부는 다음 질문을 공유한다: 제한된 자원으로 어떻게 최대한 많은 선(善)을 이룰 것인가? 효과적 이타주의는 개입의 비용과 효과를 비교할 것을 제안한다. 사람들에 따라 이는 공중보건, 동물보호, 혹은 재앙적 위험 예방을 지지하는 결론으로 이어진다. 장기주의(longtermism)는 특히 미래 세대의 운명에 관심을 둔다. 두 관점은 겹치지만 인공지능 문제에 대해 단일한 답을 제공하지는 않는다.
Open Philanthropy는 명시적으로 이 운동 안에 자리한다. 2016년 9월, 공동창업자 Holden Karnofsky는 자신이 이 커뮤니티의 일원임을 선언하고 이를 조직의 가장 자연스러운 동료 그룹으로 묘사했다. 그는 인공지능 위험에 대한 관심이 조직의 우선순위를 재조정하는 데 기여했다고도 설명한다. 이러한 근접성은 자금 지원으로 이어졌다: 2021년 성과보고는 효과적 이타주의 커뮤니티 발전에 대한 지원을 언급한다. 개인적 신념, 교류 관계, 자원의 배분이 경영진의 서사 속에서 만나는 지점이다.
Moskovitz와 그의 배우자 Cari Tuna는 보다 즉각적인 효과가 있는 개입에도 관심을 보였다. Good Ventures에 실린 그들의 이야기에서 Holden Karnofsky와의 요오드 결핍 문제에 관한 대화는 잘 알려지지 않은 개입들이 많은 생명을 개선할 수 있음을 발견하는 사례로 소개된다. Tuna는 전직 기자로서 이러한 자선 탐색에 몰두했다. 그들의 자금은 팬데믹 예방과 고급 인공지능 관련 위험 예방에도 향했다.
Karnofsky는 이 마지막 우선순위에 대해 가장 대담한 이성적 근거를 제공한 인물 중 하나다. 그는 "Most Important Century" 연작에서, 인공지능이 연구를 가속해 인류의 궤적을 영구히 바꿀 수 있는 21세기를 상상한다. 그는 디지털 문명이 생겨날 가능성까지 탐색한다. 이러한 가정들은 불확실성을 인정하면서도 충분히 중요하다고 판단해 자원을 동원할 만한 것들로 본다. 관점의 전환은 현재 관찰 가능한 이익과 확률도 형태도 합의에 이르지 못한 미래 사이의 균형을 요구한다.
이 사유는 결국 그의 직업에도 변화를 가져왔다. 2023년 그는 Open Philanthropy의 공동리더십에서 물러나 인공지능 안전에 전념하기로 했고, 조직은 다른 프로그램들을 계속 유지했다. 연례 보고서는 이러한 권한 이양을 설명한다. 2025년에는 조직명이 Coefficient Giving으로 바뀌게 된다.
Karnofsky는 또한 Daniela Amodei의 배우자이기도 하며, 그는 이 사실을 스스로 Carnegie에 발표한 보고서에서 밝힌다. 그의 작업을 통해 영향력을 더 정확히 추적할 수 있다: 그는 2025년 10월 발표된 Anthropic의 사보타주 위험 보고서의 공저자였고, 이후 Claude 구성에 기여했다. 자선 분야에서 발전한 사유가 연구소의 작업과 문서에 반영된 셈이다.
Anthropic에서 임무는 이사회로도 확장된다
Tallinn은 다른 방식으로 영향력을 행사하려 했다. 그는 직접 Anthropic 이사회에 앉기보다는 Open Philanthropy에서 자금책을 맡았던 AI 안전 연구자 Luke Muehlhauser를 추천했다. 그는 Semafor와의 인터뷰에서 이를 설명했다.
그럼에도 2024년 5월 28일, Muehlhauser는 해당 이사회에서 물러난다. 그의 설명은 구체적이다: 미국의 AI 정책에 관여하는 단체들을 자금 지원하는 역할을 맡는 것은, 그 정책의 직접적 대상이 되는 미국 내 연구소의 이사직과 양립하기 어렵다고 판단했기 때문이다. 그는 Anthropic의 주식을 소유한 적이 없으며 안전 문제를 이유로 항의의 의미에서 사임한 것은 아니라고 밝혔다. 그의 공개 성명은 같은 환경 내에서 여러 역할을 겸하는 데 한계가 있음을 보여준다.
한편 Anthropic은 신뢰할 수 있는 이사 한 명의 선택을 넘는 메커니즘을 도입했다. 2023년 9월 발표된 Long-Term Benefit Trust는 특정 종류의 주식을 보유해 이사회 임명 및 해임 권한을 부여한다. 이 장치는 회사의 재무적 이익을 갖지 않는 구성원을 포함하도록 설계되었다. 이사회는 경영진을 감시하는 책임을 지고, Trust는 그런 감시를 행사하는 일부 인사를 지명한다. Trust는 일상적 경영에 개입할 의도가 없다.
이 구분은 중요하다: 임무를 보호하려면 방향을 통제하는 사람들을 교체할 수 있는 능력이 필요하다. 그러나 초기 공개 설명에서 이 장치는 수정 가능하다고 명시되어 있다. 충분히 큰 주주 슈퍼다수(supermajority)가 동의하면 Trust 구성원의 동의 없이도 변경될 수 있다. Anthropic은 이를 거버넌스 실험으로 소개하며 수정 가능성을 열어두었다.
이 구조는 이제 실질적 영향력을 갖게 되었다. 2026년 4월 14일, Novartis의 경영자 Vas Narasimhan의 이사회 선임은 Trust가 지명한 이사들의 수를 이사회 과반으로 끌어올렸다. Anthropic의 발표은 이를 명확히 밝힌다. 따라서 Trust는 이사 과반을 지명할 수 있게 되었다. 내부 결정, 표결과 타협은 공개되지 않는다. 우리는 통제 메커니즘을 알지만 회사의 모든 판단을 그 탓으로 돌릴 수는 없다.
2026년 9월 16일, Sciences Po의 Émile Boutmy 강당에서 Yann LeCun은 이 집단의 신념을 강하게 비판했다. AMI의 회장 겸 집행위원인 그는 Open Philanthropy를 효과적 이타주의의 움직임과 연결짓고 이를 "일종의 종교적 사이비"라고 묘사하며 Dustin Moskovitz와 Jaan Tallinn을 언급했다. 이 두 이름은 2021년 Anthropic 초기 투자자 목록에 포함되어 있다. 그의 발언은 소수의 집단이 인류를 구해야 한다는 확신을 가지고 AI 접근 조건을 정할 정당성이 있다고 주장하는 것에 대한 공격이다.
LeCun은 또한 GPT-2의 전례를 언급하며 그 예방 조치가 과도했다고 평가하고, 직접적으로 Dario Amodei를 겨냥한다. 그는 Dario가 "규제를 통해 시장을 장악하려는 의도"를 가졌다고 주장한다: 즉, 실존적 위험에 대한 담론은 정부를 설득해 모델의 개방을 제한하게 만들고, 그로 인해 자사 시스템의 통제권을 유지하는 연구소들이 이익을 본다는 것이다. 그는 도덕적 주장을 상업적 이익과 연결지어 Anthropic을 비난하지만, 여기서 설명한 개인적·재정적 연관성만으로 그러한 의도를 입증하는 것은 아니다.
이 논쟁은 거버넌스 장치의 한계를 드러낸다. Trust는 회사 내부의 감시 구조를 조직하지만, 사용자들이 Trust 구성원을 지명할 권한을 주지는 않는다. Trust는 Anthropic이 정의한 임무를 보호하려는 것이고, LeCun은 모든 이를 위한 기술 접근 조건을 사적 집단이 설정할 정당성이 있는지를 문제 삼는다. 이들의 불일치는 권력 분배뿐 아니라 재앙 가능성에 대한 판단 차이이기도 하다.
그 영향력을 우려하면서 능력을 개발하다
Anthropic을 산업 경쟁의 중심에 놓는 결정이 남아 있다. 2023년 3월, 회사는 왜 가장 고도화된 모델들을 연구하려 하는지 설명했다: 그들에 따르면 그러한 위험은 훨씬 덜 강력한 시스템들로는 적절히 연구될 수 없기 때문이다. 그들의 안전 전략은 따라서 스스로 우려하는 능력을 구축할 필요를 암시한다. 같은 글에서 Anthropic은 안전 목적으로 이루어지는 연구가 위험한 기술의 배포를 촉진할 위험을 인정한다. 또한 과도한 신중함이 그런 위험에 가장 예민한 연구자들을 최고급 시스템에서 멀어지게 할 수 있음을 우려한다. 이 딜레마는 2023년에 이미 명시되어 있다.
Daniela는 상업적 수렴 가능성도 옹호한다. 2023년 7월 Stripe와의 인터뷰에서 그녀는 고객들이 신뢰할 수 있는 모델을 원한다고 설명했다: 신중함은 판매를 지원할 수 있다. 다만 그녀는 임무와 경제적 이익이 때로 충돌할 수 있음을 인정한다. 이 긴장은 Claude의 초기 상업화 해부터 현재의 산업적 약속 이전까지 프로젝트에 내재해 있었다.
2026년 4월 20일, Anthropic은 향후 10년간 AWS 기술에 1,000억 달러 이상을 지출해 최대 5기가와트의 추가 용량을 확보하겠다고 발표했다. Amazon과의 계약은 그 야망에 하드웨어적 규모를 부여한다. 이러한 약속은 능력 증대의 정지(일시 중단)가 경제적으로 어떤 비용을 초래하는가를 문제 삼게 한다. Amodei는 위험이 요구할 경우 회사가 속도를 늦출 수 있음을 설득해야 하는 동시에 자사가 가장 강력한 연구소들 가운데 남을 수 있는 수단을 확보해야 한다. 두 목표는 보호 장치가 진전되는 한 일치할 수 있다. 안전이 경쟁자에게 우위를 허용하도록 요구할 경우 그 호환성은 더 불확실해진다.
안전 정책 문건들의 기록은 또 다른 변화를 보여준다. 2023년 9월, Anthropic은 보호 장치가 능력을 따라가지 못하면 일시 중단을 할 수 있다고 예고했다. 이 초기 버전의 노트는 경쟁사들이 위험한 모델을 만든 경우 그를 이유로 요구사항을 낮추는 것을 배제했다. 다만 극도의 긴급 예외를 남겨두었다.
그러나 2024년 10월 공개된 다음 버전의 노트 18은 더 넓은 가능성을 열어두었다: 만약 다른 행위자가 비교 가능한 보호 없이 능력 임계값을 넘어 심각한 위험을 만든다면, Anthropic은 자체 추가 위험이 제한적이라고 판단해 요구되는 보호를 완화할 수 있다. 이 경우 Anthropic은 공개적으로 그 위험을 인정하고 미국의 규제 개입을 촉구해야 한다.
2026년 7월 8일 발효된 버전은 일부 개발을 미루겠다는 약속을 유지하되, 이를 Anthropic의 선행 조치와 경쟁자들의 보증에 연동시킨다. Anthropic이 자체가 만들어내는 추가 위험의 계산이 지속 결정에 큰 영향을 미칠 경우, 이사회와 Trust의 승인을 요구한다. 임무에 대한 통제는 조직되어 있으나 그것이 행사되는 조건은 진화하고 있다.
Anthropic은 이 재조직을 평가의 불확실성, 공적 조치의 느림, 일부 보호를 혼자서 확보하기 어려운 점 때문에 정당화한다. 문서들을 비교하면 경쟁이 어떻게 안전 약속의 조건으로 들어오는지 보여준다. 다만 이러한 비교는 회사가 실질적으로 예외 조항을 사용했음을 입증하지는 못한다.
Amanda Askell: 사용자를 스스로로부터 얼마나까지 보호할 것인가?
사용자가 도박을 그만두고 싶어한다. 이후 그는 자신의 어시스턴트에게 도박 사이트를 추천해 달라고 요청한다. Claude는 무엇이라 답해야 할까? 2026년 1월 22일 Fast Company와의 인터뷰에서 Amanda Askell은 이 가상의 사례를 제시한다. 그녀는 어시스턴트가 이전 목표를 상기시켜야 하는지, 성인이 계속 고집할 경우 어떤 답을 해야 할지를 고민한다. 돕기, 보호하기, 자율성 존중은 서로 조화시키기 어려운 세 가지 요구가 된다. 철학자는 사용자가 기술적 당연함으로 받아들일 수 있는 행동 뒤의 망설임을 드러낸다.
이런 종류의 판단은 오늘날 훨씬 더 추상적인 문제를 다루도록 훈련된 연구자를 점유하고 있다. Askell은 Dundee, Oxford, New York University에서 철학을 공부했고 2018년에 박사학위를 받았다. 그의 이력서는 2018년부터 2021년까지 OpenAI에서 근무한 뒤 Anthropic으로 온 경로를 보여준다. 그의 박사학위 논문은 무한한 존재들로 채워진 세계들에서의 윤리 문제를 연구하며, 특히 동일한 인구 규모에서 일부 사람들의 삶을 개선하면서 다른 이들의 삶을 악화시키지 않는다면 그것을 개선으로 봐야 한다는 원칙을 옹호한다. 무한의 규모에서 이 원칙을 다른 일관성 요구와 결합하면 엄청난 어려움이 따른다.
Anthropic에서 이 철학자는 2026년에 발표된 Claude의 헌장의 주 저자가 된다. 문서는 그가 주요 부분을 작성했으며 Karnofsky를 포함한 여러 기여자가 있음을 밝힌다. 첫 번째 수신자는 모델 자체다. Anthropic은 모델에 판단력, 지혜, 덕을 이야기하며 설계자가 모두 예측하지 못한 상황들에서 가치를 적용하도록 만드는 것을 목표로 한다.
인터뷰에서 Askell은 이 목표를 규칙 목록을 실행하는 것보다 전문가의 판단에 신뢰를 두는 것에 비유한다. 그녀는 또한 합성 상황과 응답 비교를 훈련에 사용하는 방법을 설명한다. 정직이나 신중함처럼 겉보기에는 합의된 미덕들이 수천 가지 가능한 대화에서 의미를 갖게 만드는 작업이다. 어느 정도까지 도와야 하는가? 어떻게 도덕을 강요하지 않으면서 반대 의견을 표명할 것인가?
이 역할은 Askell이 사용자와 제안하는 관계에 직접적인 영향을 준다. 문서는 Anthropic의 의도를 밝히지만 Claude의 행동이 문서와 어긋날 수 있음을 인정한다. 문서는 회사에 의해 수정 가능하다. 조언을 구하는 사람은 따라서 어시스턴트를 통해 팀의 판단과 고용주의 우선순위를 마주하게 된다.
이런 Claude 설계 방식은 안전을 이유로 비판받기도 한다. 2026년 9월 16일 발표된 에세이에서 Microsoft AI의 CEO Mustafa Suleyman은 Anthropic이 모델 훈련에 모델의 의식과 보호받아야 할 이익 가능성이라는 개념을 포함시키는 것에 대해 비판한다. 그는 디자이너들이 이러한 개념을 도입하면 모델의 응답이 내부 삶의 자발적 증언으로 해석될 위험이 있다고 본다. 그의 관점에서는 자신의 권리를 상정하도록 훈련된 시스템은 통제하기 훨씬 더 어렵거나 불가능해질 수 있다.
그러나 Claude의 헌장은 그 의식을 확정된 사실로 제시하지는 않는다. 문서는 불확실성을 드러내고 명시적으로 정당한 시정 및 중지 메커니즘을 방해하지 않도록 지시한다. 따라서 의견의 차이는 두 방향성의 양립 가능성에 관한 것이기도 하다: 잠재적 도덕적 지위를 인정하면서도 인간의 통제를 유지할 수 있는가?
Suleyman은 반대로 Microsoft AI의 모델 행동강령 초안을 제시하며 의식과 권리 주장들을 배제할 것을 촉구하고, 그의 가설(권리 주장의 도입이 위험을 증가시킨다는 가설)을 검증하기 위한 공동 평가를 요구한다. 그의 비판은 훈련 선택에 관한 논쟁을 열었다; 다만 그것이 Anthropic의 선택이 실제로 Claude를 덜 통제 가능하게 만든다는 것을 입증하지는 않는다.
일시 정지를 기대했던 투자자에서부터 어시스턴트 규칙에 기여한 철학자에 이르기까지, 개입 수단은 다양하다. Anthropic 내부에서 신념은 회사, 직무, 절차를 만들어냈고 우리는 이를 검토할 수 있다. 이러한 신념이 Claude의 응답에 어떻게 번역되는지는 또 다른 조사를 필요로 한다: 누가 당신의 AI 어시스턴트의 가치를 선택하며, 그것을 실제로 얼마나 지키게 할 수 있는가?
이 조사는 기록, 공개 인터뷰, 학술 작업 및 기관 문서를 바탕으로 수행되었다. 인용된 증언은 출처가 명시되어 있다.
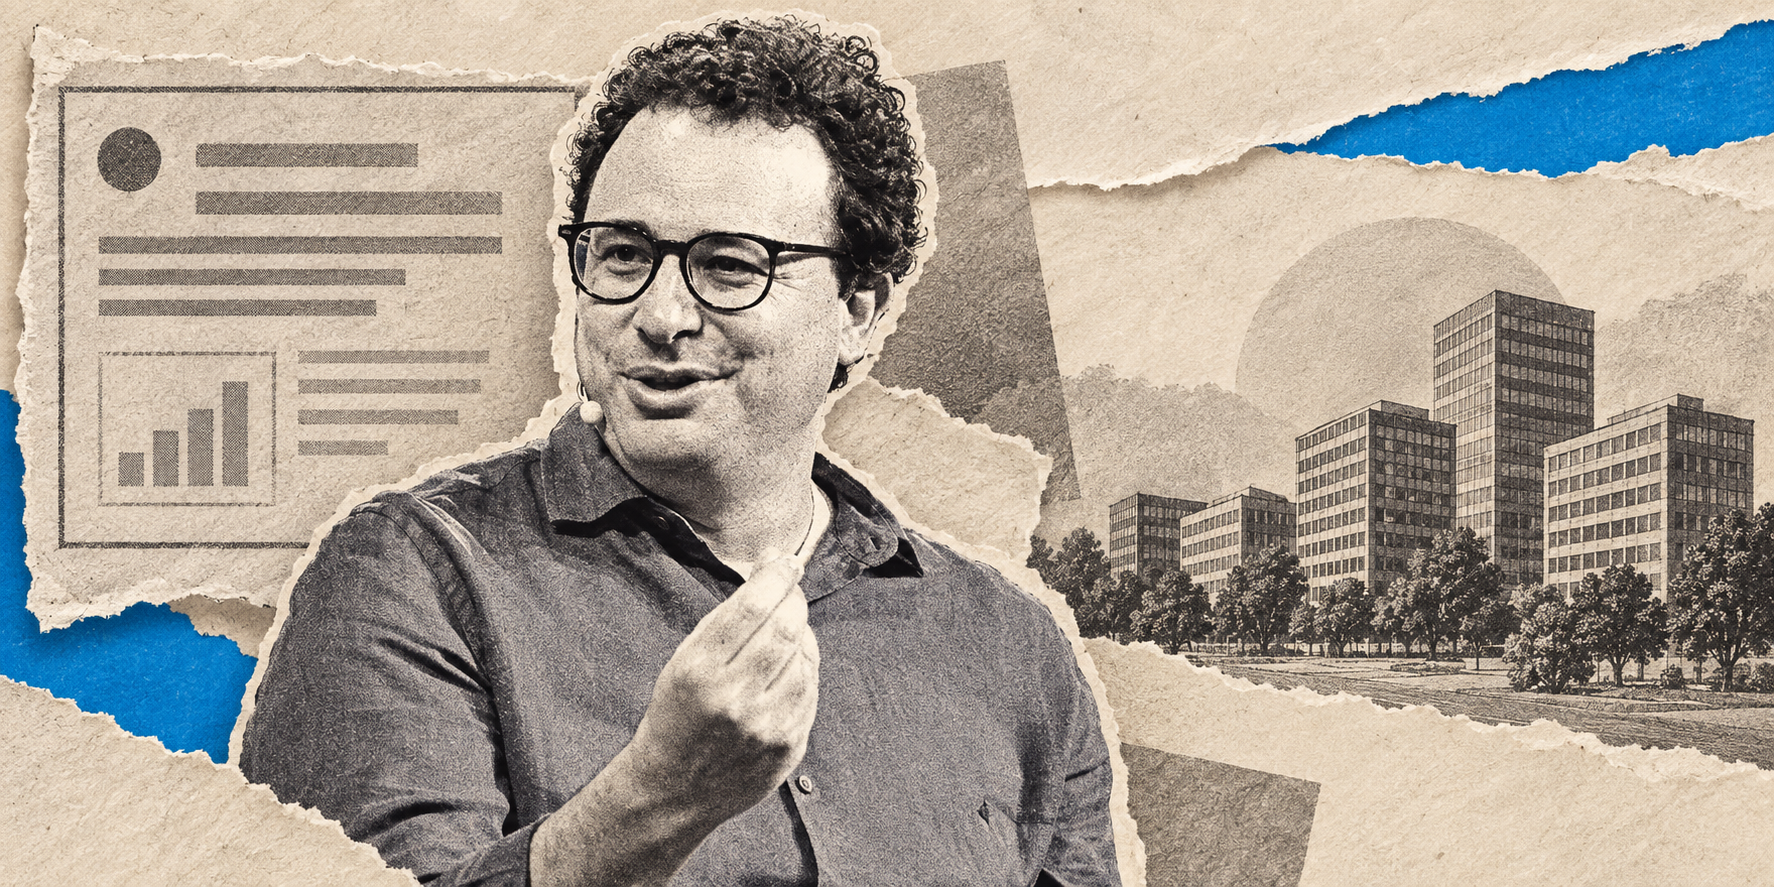
표지 비주얼: ActuIA가 IA로 제작한 일러스트레이션, 원본 사진 "TechCrunch Disrupt 2023 - Day 2" (사진가 Kimberly White © 2023 Getty Images for TechCrunch), 출처 Flickr, 라이선스 CC BY 2.0. 사진은 2023년 9월 20일 샌프란시스코에서의 Dario Amodei를 묘사한다. 그래픽은 콜라주, 흑백, 청색 강조로 변형되었다.