Uno dei suoi primi investitori voleva orientare l’IA verso maggiore prudenza. Due anni dopo la creazione di Anthropic, giudicava la sua strategia di investitore un fallimento. Dietro Claude, le convinzioni dei fondatori hanno però plasmato le assunzioni, la governance e il prodotto. Ma chi può imporre una scelta quando la missione incontra le esigenze della crescita?
Ad aprile 2023, Jaan Tallinn ha un motivo preciso di delusione. Il cofondatore di Skype ha finanziato laboratori di intelligenza artificiale, tra cui Anthropic, sperando di influenzarne la prudenza. L’azienda però non ha firmato l’appello a sospendere per sei mesi l’addestramento dei sistemi più potenti. L’iniziativa proveniva in particolare dal Future of Life Institute, che lui stesso ha cofounded.
«Plan A failed», confida a Semafor. Il piano A è fallito. Anthropic risponde che non firma petizioni per principio. Tallinn continua tuttavia a giudicarla più attenta alla sicurezza rispetto ad altri laboratori che conosce. Questo dissenso, riportato il 28 aprile 2023, si riassume in poche righe: condividere una preoccupazione, finanziare chi la prende sul serio e ottenere una decisione sono tre cose diverse.
Questa difficoltà attraversa la storia di Anthropic. L’azienda ha dato alle preoccupazioni sulla sicurezza uno spazio nella ricerca, poi nelle regole di governance. Ha anche assunto persone, raccolto capitali e preso impegni industriali che la collocano nella competizione che voleva rendere meno pericolosa. Per capire le sue scelte, bisogna seguire le persone nel momento in cui le loro convinzioni diventano responsabilità.
Dopo OpenAI, costruire un’organizzazione attorno a una scommessa
La storia inizia in un’altra organizzazione. Nel dicembre 2015, Sam Altman e Elon Musk presentano OpenAI come un organismo di ricerca non profit. Il beneficio collettivo dell’IA figura già al centro di l’annuncio fondatore, conservato da Internet Archive. Questa ambizione precede dunque Anthropic e la competizione tra le due aziende. Gli Amodei lavoreranno in OpenAI prima di andare a fondare il proprio laboratorio, all’inizio del 2021.
La prudenza di Amodei si era già tradotta in una restrizione concreta. Il 14 febbraio 2019, in OpenAI, egli cosigna l’annuncio che giustifica il non pubblicare immediatamente la versione più potente di GPT-2, per i rischi di uso malevolo. Una versione ridotta viene diffusa; il modello completo diventa accessibile il 5 novembre successivo, dopo una pubblicazione a tappe. Amodei sostiene quindi pubblicamente una decisione collettiva di diffusione limitata, quasi due anni prima di cofondare Anthropic. Sviluppare un modello, valutarne i pericoli e decidere chi può accedervi fanno già parte dello stesso arbitraggio.
Per riunirsi, i sette fondatori di Anthropic devono allora fare i conti con la pandemia. Si incontrano all’aperto, talvolta in un giardino, con mascherine e a distanza. Daniela Amodei racconterà questi inizi in un colloquio con il Future of Life Institute, pubblicato nel marzo 2022. Il gruppo si conosce già e vuole riunire ricerca sulle capacità dei modelli e ricerca sulla loro sicurezza in una stessa organizzazione.
Dario Amodei spiega lì la separazione: la loro scommessa esisteva già all’interno di una struttura più ampia; ora desideravano un’azienda che potesse orientare tutte le sue decisioni strategiche attorno a essa. In questa narrazione dei fondatori, la rottura del 2021 sta nella possibilità di scegliere una direzione comune e dedicarle l’intera organizzazione.
I due fratelli non portano le stesse competenze. Dario, il CEO, viene dalla fisica e dalle neuroscienze. Daniela, la presidente, ha studiato letteratura, con una minor in politica, a UC Santa Cruz. Nel colloquio del 2022 ricostruisce anche un percorso nelle ONG e nella politica a Washington. Le loro questioni morali non iniziano con Claude: nel 2003, il giornale studentesco del Caltech descrive già l’impegno di Dario contro la guerra in Iraq e le sue preoccupazioni sulla responsabilità degli scienziati.
Questa vicinanza ha effetti molto concreti. Intervistata nel luglio 2023 sul numero di fisici nel team, Daniela riconosce l’importanza delle loro reti. Per far crescere il gruppo bisogna poi tenere riunioni, assumere, decidere. Racconta di provare a preservare qualche ora di riflessione all’inizio della giornata e di incontrare i nuovi dipendenti, esercizio diventato più difficile con la crescita. In questo colloquio pubblicato da Stripe, partner commerciale di Anthropic, la missione si traduce anche nel lavoro di una dirigente che cerca di conservare una cultura comune quando gli organici aumentano.
Come la filantropia entra nel laboratorio
Ci vogliono soldi per trasformare questo gruppo in azienda. Il primo round annunciato, nel maggio 2021, porta 124 milioni di dollari. Jaan Tallinn lo guida; Dustin Moskovitz, cofondatore di Facebook, fa parte degli investitori. I loro nomi figurano in l’annuncio di questo finanziamento.
Una parte di questo ambiente condivide una domanda: con risorse limitate, come fare il maggior bene possibile? L’altruismo efficace propone di confrontare interventi, costi ed effetti. A seconda delle persone, porta a sostenere la sanità pubblica, la protezione animale o la prevenzione dei rischi catastrofici. Il longtermismo pone più specificamente attenzione al destino delle generazioni future. Le due linee si sovrappongono, senza dare una risposta unica alla questione dell’IA.
Open Philanthropy si colloca esplicitamente in questo movimento. Nel settembre 2016, il suo cofondatore Holden Karnofsky si dichiara membro di questa comunità e la descrive come il gruppo di pari più naturale per l’organizzazione. Spiega anche che il suo crescente interesse per i rischi dell’IA ha contribuito a riorientare le priorità dell’organizzazione. Questa vicinanza si traduce in finanziamenti: il bilancio del 2021 menziona il sostegno allo sviluppo della comunità dell’altruismo efficace. Le convinzioni personali, gli interlocutori e l’allocazione delle risorse si congiungono qui nel racconto degli stessi dirigenti.
Moskovitz e sua moglie Cari Tuna si interessano anche a interventi dagli effetti più immediati. Nel racconto pubblicato da Good Ventures una conversazione con Holden Karnofsky sulle carenze di iodio illustra la scoperta di interventi poco noti che possono migliorare molte vite. Tuna, ex giornalista, si dedica a questa esplorazione filantropica. I loro finanziamenti andranno anche alla prevenzione delle pandemie e ai rischi legati all’IA avanzata.
Karnofsky è uno di quelli che dà a quest’ultima priorità il ragionamento più ambizioso. Nella sua serie «Most Important Century» immagina un XXI secolo in cui le IA accelerano la ricerca al punto da modificare in modo duraturo la traiettoria dell’umanità. Esplora fino alla possibilità di civiltà digitali. Sono ipotesi che ritiene sufficientemente importanti da mobilitare sforzi, pur riconoscendone l’incertezza. Lo spostamento è notevole: porta a mettere in bilancio benefici osservabili oggi e futuri la cui probabilità e forma non fanno consenso.
Questa riflessione finisce per cambiare il suo mestiere. Nel 2023 lascia la codirezione di Open Philanthropy per concentrarsi sulla sicurezza dell’IA; l’organizzazione mantiene gli altri programmi. Il suo resoconto dell’anno descrive questo passaggio di consegne. Nel 2025 prenderà il nome di Coefficient Giving.
Karnofsky è anche il marito di Daniela Amodei, legame che lui stesso dichiara in un rapporto pubblicato dal Carnegie. Il suo lavoro permette di seguire più precisamente la sua influenza: è coautore di un rapporto di Anthropic sui rischi di sabotaggio, di ottobre 2025, poi contribuente alla costruzione di Claude. Una riflessione sviluppata nella filantropia si ritrova quindi in lavori e testi usati dal laboratorio.
In Anthropic, la missione passa anche dal consiglio
Tallinn aveva cercato un altro modo di agire. Piuttosto che sedere lui stesso nel consiglio di Anthropic, aveva proposto Luke Muehlhauser, ricercatore in sicurezza dell’IA e responsabile dei finanziamenti in Open Philanthropy. Lo racconta in l’intervista a Semafor.
Il 28 maggio 2024, Muehlhauser lascia però quel consiglio. La sua spiegazione è concreta: finanziare organizzazioni che lavorano anche sulla politica americana dell’IA diventa difficile da conciliare con un mandato in un laboratorio americano direttamente interessato da quella politica. Specifica di non aver mai posseduto azioni Anthropic e nega una dimissione di protesta sulla sicurezza. La sua dichiarazione pubblica mostra il limite di una sovrapposizione di ruoli nello stesso ambiente.
Nel frattempo, Anthropic ha installato un meccanismo che va oltre la scelta di un amministratore fidato. Presentato nel settembre 2023, il Long-Term Benefit Trust detiene una categoria particolare di azioni che conferiscono diritti di nomina e revoca al consiglio. Il dispositivo prevede membri senza interesse finanziario nell’azienda. Il consiglio resta incaricato di sorvegliare i dirigenti; il Trust nomina una parte di coloro che esercitano questa sorveglianza. Non ha lo scopo di intervenire nella gestione quotidiana.
La distinzione è essenziale: proteggere una missione suppone qui poter cambiare le persone che controllano la direzione. Dalla sua presentazione iniziale, il dispositivo resta comunque modificabile, anche senza l’accordo dei membri del Trust se supermaggioranze di azionisti sufficientemente importanti lo accettano. Anthropic lo presenta come un’esperienza di governance, con possibilità di correzione.
Questa costruzione ora ha un peso reale. Il 14 aprile 2026, la nomina di Vas Narasimhan, dirigente di Novartis, porta alla maggioranza del consiglio il numero di amministratori designati dal Trust. L’annuncio di Anthropic lo dichiara esplicitamente. Il Trust può quindi designare la maggioranza degli amministratori. Le decisioni interne, i voti e i compromessi non sono però resi pubblici. Si conosce il meccanismo di controllo; non gli si può attribuire ogni singolo arbitraggio dell’azienda.
Il 16 settembre 2026, nell’aula Émile Boutmy di Sciences Po, Yann LeCun mette duramente in discussione le convinzioni di questo ambiente. Il presidente esecutivo di AMI collega Open Philanthropy alla corrente dell’altruismo efficace, che assimila a «una specie di setta religiosa», prima di evocare tra gli altri Dustin Moskovitz e Jaan Tallinn. Questi due nomi figurano tra gli investitori del primo round annunciato da Anthropic nel 2021. Il suo intervento attacca l’idea che un piccolo gruppo, convinto di dover salvare l’umanità, sia particolarmente legittimato a decidere l’accesso all’IA.
LeCun ritorna anche sul precedente di GPT-2, le cui precauzioni giudica eccessive, e prende di mira direttamente Dario Amodei. Gli attribuisce la volontà di «catturare il mercato tramite la regolazione»: secondo lui, i discorsi sul rischio esistenziale servirebbero a convincere i governi a restringere i modelli aperti, a vantaggio dei laboratori che mantengono il controllo dei loro sistemi. Collega così una convinzione morale dichiarata a un interesse commerciale presunto. È l’accusa che muove contro Anthropic; i legami personali e finanziari descritti qui non bastano a dimostrare questa intenzione.
La controversia illumina un limite del dispositivo di governance. Il Trust organizza una sorveglianza interna dell’azienda; non conferisce agli utenti il potere di designare i suoi membri. Mira a proteggere una missione definita da Anthropic, mentre LeCun contesta la legittimità di un gruppo privato a fissare le condizioni di accesso a una tecnologia destinata a tutti. Il disaccordo riguarda tanto la distribuzione del potere quanto la probabilità di una catastrofe.
Sviluppare capacità di cui si temono gli effetti
Resta la scelta che pone Anthropic al centro della corsa industriale. Nel marzo 2023, l’azienda espone perché vuole lavorare sui modelli più avanzati: secondo lei, i loro rischi non possono essere adeguatamente studiati a partire da sistemi molto meno potenti. La sua strategia di sicurezza implica dunque di costruire le capacità di cui si preoccupa. Nello stesso testo, Anthropic riconosce il rischio che una ricerca motivata dalla sicurezza acceleri il dispiegamento di tecnologie pericolose. Temono anche che un eccesso di prudenza allontani i ricercatori più attenti da questi rischi dai sistemi più avanzati. Questo dilemma è esplicitato già nel 2023.
Daniela difende anche una convergenza commerciale. Nel luglio 2023 spiega a Stripe che i clienti cercano modelli affidabili: la prudenza può sostenere le vendite. Riconosce però che missione e interesse economico possono talvolta entrare in conflitto. Questa tensione è inscritta nel progetto fin dai primi anni di commercializzazione di Claude, prima degli impegni industriali attuali.
Il 20 aprile 2026, Anthropic annuncia di impegnarsi a spendere oltre 100 miliardi di dollari in tecnologie AWS in dieci anni, per ottenere fino a 5 gigawatt di capacità aggiuntiva. L’accordo con Amazon dà una scala materiale alla sua ambizione. Questi impegni pongono anche la questione del costo economico di una pausa nell’aumento delle capacità. Amodei deve convincere che la sua azienda saprà rallentare se il rischio lo richiede, pur dandole i mezzi per restare tra i laboratori più potenti. I due obiettivi possono coincidere finché le protezioni progrediscono. La loro compatibilità diventa più incerta se la sicurezza impone di lasciare un concorrente prendere il vantaggio.
Gli archivi della sua politica di sicurezza mostrano un altro cambiamento. Nel settembre 2023, Anthropic prevede una pausa se le protezioni non seguono le capacità. Una nota di quella prima versione esclude i modelli pericolosi dei concorrenti dalle ragioni che permetterebbero di abbassare i requisiti. Il documento comunque prevede un’eccezione per un’emergenza estremamente grave.
Già nell’ottobre 2024, la nota 18 della versione successiva apre una possibilità più ampia: se un altro attore supera una soglia di capacità senza protezioni comparabili e crea un rischio serio, Anthropic potrebbe ridurre le protezioni richieste, ritenendo il proprio rischio addizionale limitato. Dovrebbe allora riconoscere pubblicamente il rischio e fare pressione per un intervento regolatorio americano.
La versione entrata in vigore l’8 luglio 2026 conserva impegni a differire certi sviluppi, ma li articola con l’avanzamento di Anthropic e le garanzie dei suoi concorrenti. Quando il calcolo del rischio addizionale creato da Anthropic pesa fortemente nella decisione di proseguire, essa richiede l’approvazione del consiglio e del Trust sul rapporto di rischi. Il controllo della missione resta organizzato; le condizioni in cui si esercita evolvono.
Anthropic giustifica questa riorganizzazione con l’incertezza delle valutazioni, la lentezza dell’azione pubblica e la difficoltà di assicurare da sola certe protezioni. Il confronto dei testi mostra come la competizione entri nelle condizioni della promessa di sicurezza. Non prova che l’azienda abbia effettivamente usato l’eccezione.
Amanda Askell: fino a che punto proteggere l’utente da se stesso?
Un utente vuole smettere con il gioco d’azzardo. Più tardi chiede al suo assistente di raccomandargli siti di scommesse. Cosa dovrebbe rispondere Claude? In un colloquio pubblicato da Fast Company il 22 gennaio 2026, Amanda Askell propone questo caso ipotetico. Immagina che l’assistente ricordi l’obiettivo precedente, poi si interroghi sulla risposta se l’adulto insiste. Aiutare, proteggere e rispettare l’autonomia diventano tre esigenze difficili da conciliare. La filosofa mostra l’esitazione dietro un comportamento che l’utente potrebbe percepire come una evidenza tecnica.
Questo tipo di arbitraggio occupa oggi una ricercatrice formata su problemi molto più astratti. Askell ha studiato filosofia a Dundee, Oxford e poi New York University, dove ottiene il dottorato nel 2018. Il suo CV colloca poi il suo passaggio in OpenAI dal 2018 al 2021, prima di Anthropic. La sua tesi sull’etica in mondi infiniti esamina come confrontare mondi popolati da un’infinità di esseri il cui benessere varia. Difende in particolare un principio: a parità di popolazione, migliorare le condizioni di alcuni senza peggiorare quelle degli altri deve contare come miglioramento. Su scala infinita, articolare questo principio con altre esigenze di coerenza solleva difficoltà formidabili.
In Anthropic, questa filosofa diventa l’autrice principale della costituzione di Claude pubblicata nel 2026. Il testo specifica che ella ne ha scritto la maggior parte, con diversi contributori, tra cui Karnofsky. Il suo primo destinatario è il modello stesso. Anthropic parla di giudizio, saggezza e virtù, con l’ambizione di far applicare al modello dei valori in situazioni che i progettisti non hanno tutte previste.
Nel colloquio, Askell paragona questa ambizione alla fiducia riposta nel giudizio di un professionista, piuttosto che all’esecuzione di una lista di istruzioni. Descrive anche la creazione di situazioni sintetiche e di confronti di risposte per l’addestramento. Qualità apparentemente consensuali, come onestà o prudenza, devono così prendere senso in migliaia di conversazioni possibili. Fino a che punto aiutare? Come esprimere un disaccordo senza imporre una morale?
Questa funzione conferisce ad Askell un’influenza diretta sulla relazione proposta all’utente. Il documento espone le intenzioni di Anthropic, che riconosce che il comportamento di Claude può discostarsene. Il testo resta revisionabile dall’azienda. La persona che chiede consiglio incontra quindi anche, attraverso l’assistente, gli arbitrati di un team e le priorità del suo datore di lavoro.
Questo modo di concepire Claude è contestato in nome della sicurezza. In un saggio pubblicato il 16 settembre 2026, Mustafa Suleyman, CEO di Microsoft AI, rimprovera ad Anthropic di integrare nell’addestramento l’idea che il suo modello potrebbe avere una coscienza e degli interessi meritevoli di protezione. Descrive un ragionamento circolare: i progettisti introducono queste nozioni, poi le risposte del modello rischiano di essere interpretate come testimonianze spontanee di una vita interiore. Secondo lui, un sistema addestrato a ipotizzare propri diritti potrebbe diventare molto più difficile, se non impossibile, da controllare.
La costituzione di Claude tuttavia non presenta la sua coscienza come acquisita. Espone un’incertezza e chiede esplicitamente al modello di non ostacolare i meccanismi legittimi di correzione o di arresto. Il disaccordo riguarda quindi anche la compatibilità di queste due direzioni: riconoscere un possibile status morale mantenendo il controllo umano.
Suleyman propone invece un codice di condotta per i modelli di Microsoft AI, sottoposto a consultazione, che esclude le rivendicazioni di coscienza e diritti. Invita a valutazioni comuni per testare la sua ipotesi di un rischio aumentato. La sua critica apre una controversia sulle scelte di addestramento; non dimostra che quelle di Anthropic rendano effettivamente Claude meno controllabile.
Dal finanziatore che sperava di ottenere una pausa alla filosofa che contribuisce alle regole dell’assistente, i mezzi di azione differiscono. In Anthropic, le convinzioni hanno prodotto un’azienda, ruoli e procedure che si possono esaminare. La loro traduzione nelle risposte di Claude apre un’altra inchiesta: chi sceglie i valori del tuo assistente, e fino a che punto può davvero farli rispettare?
Inchiesta documentaria realizzata a partire da archivi, interviste pubbliche, lavori scientifici e documenti istituzionali. Le testimonianze riportate sono attribuite alla loro fonte.
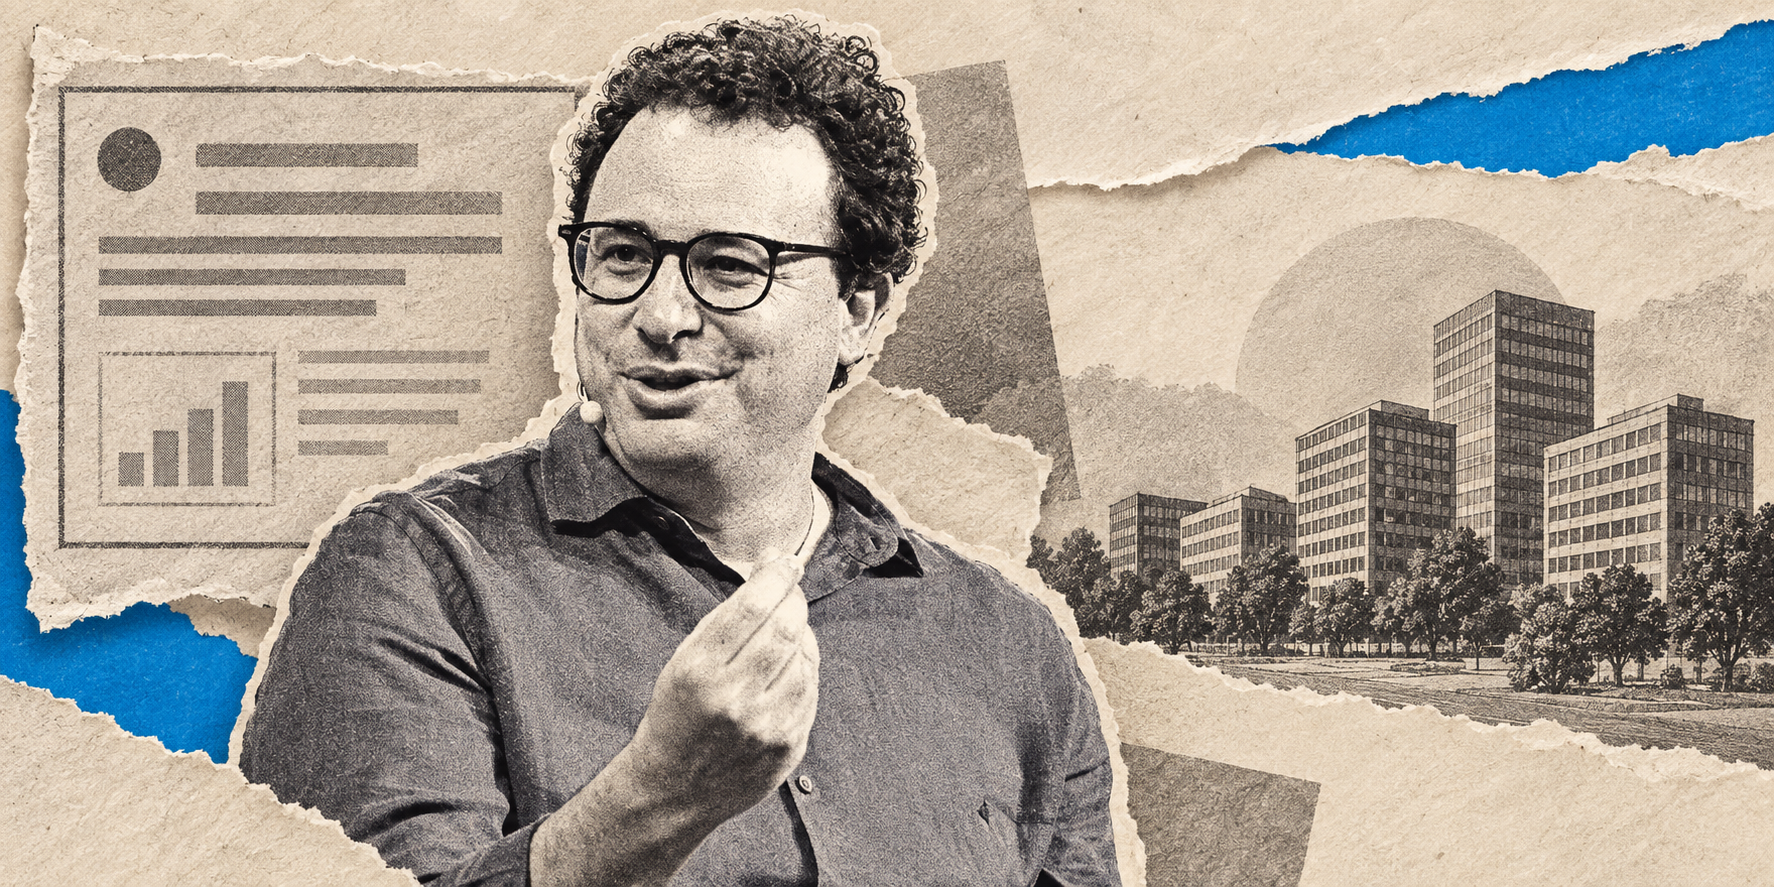
Immagine in evidenza: illustrazione ActuIA realizzata con IA a partire dalla fotografia “TechCrunch Disrupt 2023 - Day 2”, di Kimberly White (© 2023 Getty Images per TechCrunch), fonte Flickr, licenza CC BY 2.0. La fotografia ritrae Dario Amodei a San Francisco, il 20 settembre 2023. Adattamento grafico in collage, bianco e nero e accenti blu.