其早期的一位投资者曾希望把人工智能导向更谨慎的路径。Anthropic 成立两年后,他认为自己的投资策略失败了。然而,在 Claude 背后,创始人的信念确实塑造了招聘、治理和产品。但当使命遇上增长的现实,谁能强加某种选择?
2023 年 4 月,Jaan Tallinn 有充分理由感到失望。这位 Skype 联合创始人曾资助多个人工智能实验室,包括 Anthropic,希望能对它们的谨慎程度施加影响。但该公司并未在一项暂停最强系统训练六个月的呼吁上签字。该倡议部分由他共同创立的 Future of Life Institute 发起。
他对 Semafor 说,“Plan A failed”。A 计划失败了。Anthropic 回应称它原则上不签署请愿书。尽管如此,Tallinn 仍然认为 Anthropic 比他所熟知的其他实验室对安全更为关注。2023 年 4 月 28 日的这则报道用几行话概括了分歧:表达担忧、资助那些认真对待担忧的人、以及促成某项决策,是三件不同的事情。
这种难题贯穿了 Anthropic 的历史。公司将安全考量纳入其研究,进而写入治理规则;同时它在招聘、融资和产业承诺上所做出的选择,又把它置入了那场本想让其风险更小的竞争之中。要理解这些选择,就必须追踪那些人在信念变成职责时的行动。
从 OpenAI 出发,以一个赌注构建组织
故事始于另一个组织。2015 年 12 月,Sam Altman 和 Elon Musk 将 OpenAI 介绍为一个非营利研究机构。在其创始公告(Internet Archive 存档)中,人工智能的集体福祉已被置于核心位置。这个志向先于 Anthropic 的成立以及两家公司之间的竞争。Amodei 兄妹曾在 OpenAI 工作,随后在 2021 年初离开创建了自己的实验室。
Dario 的谨慎早有具体体现。2019 年 2 月 14 日,在 OpenAI,他联署了那份说明为何不会立即公开最强 GPT-2 版本的公告,理由是滥用风险。公开时先发布了一个简化版本;完整版在随后经过分阶段发布后,于同年 11 月 5 日对外可得。由此可见,早在共同创办 Anthropic 近两年前,Amodei 就公开支持这种受限发布的集体决策:开发模型、评估其危险性并决定谁可以访问,已是同一套权衡的一部分。
为聚在一起,七位 Anthropic 创始人还须应对疫情带来的限制。他们常在室外、花园里相见,戴着口罩、保持距离。Daniela Amodei 在 2022 年 3 月发布于 Future of Life Institute 的一次采访中回忆了这些初期时光。团队成员彼此已相识,希望在同一组织内汇聚关于模型能力的研究与关于其安全性的研究。
Dario 在接受采访时解释了二者的分离:他们的赌注此前是在更大结构内存在;他们希望组建一家公司,使所有战略决策都能围绕这一赌注展开。在这段创始人叙述中,2021 年的分裂关键在于能够选定共同方向并把整个组织投入其中。
兄妹二人的专长并不相同。担任首席执行官的 Dario 来自物理学与神经科学;担任董事长的 Daniela 在UC Santa Cruz学过文学并辅修政治。她在 2022 年的采访中还回顾了自己在 NGO 与华盛顿政治领域的经历。他们的道德关切并非始于 Claude:早在 2003 年,Caltech 的学生报就描述过 Dario 反对伊拉克战争并关注科学家责任的参与。
这种紧密关联带来很平常的影响。2023 年 7 月,当被问及团队中物理学家人数时,Daniela 承认这些网络关系的重要性。要让团队成长,随后必须开会、招聘、做决定。她讲述自己尝试在每天早些时候保留几小时用于思考,并与新员工会面——但随着规模增长这变得越来越难。在Stripe(Anthropic 的商业伙伴)刊出的这次访谈中,使命也体现在一位高管努力在队伍膨胀时保持共同文化的工作上。
慈善资金如何进入实验室
要把这个团队转变为公司,需要资金。2021 年 5 月宣布的首轮融资带来 1.24 亿美元。Jaan Tallinn 牵头;Facebook 联合创始人 Dustin Moskovitz 也在投资者之列。他们的名字出现在该融资公告中。
这一圈子里,有些人共享一个问题:在资源有限的情况下,如何做出最大的善?有效利他主义主张比较各类干预、其成本与效果。不同个体会据此支持公共健康、动物保护或灾难性风险防范。长期主义更特别关注未来世代的命运。两者有重叠,但并不对人工智能问题给出唯一答案。
Open Philanthropy 明确属于这一运动。2016 年 9 月,其联合创始人 Holden Karnofsky 自称是该群体的一员,并将其描述为组织最自然的同行圈。他也表示对人工智能风险日益关注影响了该组织的优先事项。这种靠近关系以资助形式体现:2021 年报告提到对有效利他主义社区发展的支持。个人信念、对话者与资源分配在这些领导人的叙述中交织在一起。
Moskovitz 与妻子 Cari Tuna 也关注能带来更直接效果的干预。在Good Ventures 的叙述中,一次与 Holden Karnofsky 关于碘缺乏的对话,说明了他们如何发现那些虽鲜为人知却能显著改善生活的干预手段。Tuna(前记者)把精力投入到这种慈善探索中。他们的资助也流向疫情防范和与先进人工智能相关的风险。
Karnofsky 对后者提出了最宏大的推理之一。在其系列文集“最重要的世纪”中,他设想一个这样的 21 世纪:人工智能加速科研,以致长期改变人类走向,甚至有发生“数字文明”的可能。他认为这些假设足够重要,值得动员资源,尽管他也承认这些假设存在不确定性。这个视角带来了重大转移:把当下可观察到的利益与未来(其概率与形式均无共识)进行权衡。
这种思考最终改变了他的职业道路。2023 年,他辞去 Open Philanthropy 的共同领导职务,专注于人工智能安全;组织继续推进其他项目。年度报告记述了这次交接。该组织将于 2025 年更名为 Coefficient Giving。
Karnofsky 还是 Daniela Amodei 的配偶,这一关系他本人在一份由 Carnegie 发布的报告中披露。他的工作可以更清晰地追踪其影响:他是 Anthropic 在 2025 年 10 月发布的关于破坏风险的报告的合著者之一,后来也参与了 Claude 的构建。由慈善界发展出来的思考因此出现在该实验室的研究和文本中。
在 Anthropic,使命也通过董事会体现
Tallinn 曾试图通过别的方式施加影响。他没有亲自加入 Anthropic 董事会,而是提议由 Luke Muehlhauser——一位人工智能安全研究者兼 Open Philanthropy 的资助负责人——代替他入席。他在Semafor 的采访中如此说明。
然而 2024 年 5 月 28 日,Muehlhauser 还是离开了该董事会。他给出的理由很具体:资助从事美国人工智能政策等工作的组织,难以与在一家直接受该政策影响的美国实验室的董事身份兼顾。他强调自己从未持有 Anthropic 的股票,并否认这是为了对安全问题发表抗议而辞职。他的公开声明表明,在同一圈子中兼任多职存在极限。
与此同时,Anthropic 设立了一个超越单一董事选择的机制。该机构于 2023 年 9 月提出的 Long-Term Benefit Trust 持有一种特殊类别的股份,赋予其对董事会的任命与罢免权。该机制规定应有一些在公司中没有经济利益的成员。董事会仍负责监督高管;Trust 则任命部分参与监督的成员,它并非旨在干预日常管理。
这一区分至关重要:在此,保护使命意味着能够更换掌控方向的人。从其初始介绍来看,该机制仍可修改,甚至在 Trust 成员不同意的情况下,若股东中的足够大超多数通过,亦可调整。Anthropic 将其呈现为一种治理实验,并保留修正的可能。
这一构造如今已真正在发挥作用。2026 年 4 月 14 日,Novartis 负责人 Vas Narasimhan 的任命使得由 Trust 指定的董事在董事会中占据多数。Anthropic 的公告明确指出了这一点。由此 Trust 能任命董事会大多数成员。公司的内部决策、投票与妥协过程并不公开——我们知道控制机制,却无法将公司每一项决断全部归于该机制。
2026 年 9 月 16 日,在 Sciences Po 的 Émile Boutmy 礼堂,Yann LeCun 强烈质疑这一圈子的信念。AMI 的执行主席将 Open Philanthropy 联系到有效利他主义运动,并把它比作“一种宗教性的宗派”,随后点名 Dustin Moskovitz 与 Jaan Tallinn。这两位名字都出现在 Anthropic 2021 年首轮融资的投资者名单中。他的发言抨击了这样一个观点:一个自认为要拯救人类的小圈子,是否有格外的正当性来决定谁能接触人工智能。
LeCun 还回到 GPT-2 的先例,认为当时的预防措施过度,并直接指向 Dario Amodei,指责其有“通过监管捕获市场”的意图:在他看来,关于存在性风险的论述被用来说服政府限制开放模型,从而有利于那些保持对其系统控制的实验室。他把明示的道德信念与假定的商业利益联系起来。这是他对 Anthropic 的指控;文中列举的个人与财务联系并不足以证明这种意图。
这场争论揭示了治理机制的一个局限:Trust 组织了公司内部的监督,但并未赋予用户指定其成员的权力。它旨在保护 Anthropic 所界定的使命,而 LeCun 则质疑私有小团体决定对全民开放技术访问条件的合法性。他们的分歧既关乎权力的分配,也关乎发生灾难的概率判断。
研发正令人生畏的能力
还有一个选择,把 Anthropic 置于产业竞赛中心。2023 年 3 月,公司阐明了为何要研制最先进的模型:他们认为,仅凭远逊于之的系统,无法充分研究这些能力的风险。其安全战略因此要求构建那些令他们担忧的能力。在同一文件中,Anthropic 也承认出于安全动机的研究可能会加速危险技术的部署;他们同样担心过度谨慎会让最关注这些风险的研究者远离最先进系统。这个两难从 2023 年便已明确。
Daniela 也为商业汇合做了辩护。2023 年 7 月,她在接受 Stripe 采访时解释说,客户在寻找可靠的模型:谨慎可以支持销售。但她也承认使命与经济利益有时会发生冲突。这种张力自 Claude 最早商业化之年起便写入项目,先于目前的产业承诺。
2026 年 4 月 20 日,Anthropic 宣布将在十年内于 AWS 投入超过千亿美元的技术开支,以换取最多 5 吉瓦的额外算力。与 Amazon 的协议为其雄心提供了硬件层面的规模。这类承诺也提出了一个问题:若暂停扩能会带来经济代价,该如何衡量?Amodei 必须保证公司在风险要求下能够放慢步伐,同时又具备留在最强实验室之列的能力。只要保护措施进步,这两项目标可以并行;若安全要求意味着让竞争者抢先一步,则二者兼容性变得更不确定。
公司安全政策的档案显示出另一个变化。2023 年 9 月,Anthropic 设想如果保护措施跟不上能力提升则会暂停。一份最初版本的说明排除了竞争对手的危险模型作为降低其自身要求的理由,但为极端紧急情况保留了例外。
到 2024 年 10 月,下一版的第 18 条(该版本)打开了更广的可能性:如果其他参与者在没有相当保护的情况下越过某一能力阈值并造成严重风险,Anthropic 可能会降低对自身的保护要求,前提是它评估自己因此增加的额外风险有限。届时它应公开承认该风险,并呼吁美国监管干预。
2026 年 7 月 8 日生效的版本保留了推迟某些开发的承诺,但把这些承诺与 Anthropic 的前瞻性以及竞争者的保障挂钩。当 Anthropic 自认其自身额外风险在推进决定中占显著比重时,它要求董事会与 Trust 在风险报告上批准。使命的控制仍被组织起来;只是其运作条件在演变。
Anthropic 在为这种重组辩护时指出,评估存在不确定性、公共行动缓慢、单独落实某些保护手段难度大。文件版本的比较显示了竞争如何进入安全承诺的条件。它并不证明公司确已使用该例外条款。
Amanda Askell:要在多大程度上替用户做保护?
某用户想戒赌。过了一会儿,他又让助理给他推荐博彩网站。Claude 应该如何回应?在 2026 年 1 月 22 日由 Fast Company 发布的一次采访中,Amanda Askell 提出这个假设案例。她设想助理应先提醒先前的目标,然后思考若成年人坚持要求时应如何回应。帮助、保护与尊重自主权成为三项难以兼容的要求。作为哲学家的 Askell 在此显露出权衡背后的犹豫,而用户可能将这种表现视为技术上的“显而易见”。
这一类裁决如今落在一位接受过更抽象问题训练的研究者肩上。Askell 在 Dundee、Oxford 以及 New York University 学习哲学,并于 2018 年在后者取得博士学位。她的简历显示她在 2018–2021 年间曾在 OpenAI 工作,之后加盟 Anthropic。她的博士论文探讨无限世界中的伦理学问题,研究如何比较由无限多福祉不同的主体构成的世界。她主张一条原则:在人口相同的情形下,改善部分人的处境而不损害他人应被视为改进。在无限规模下,将该原则与其他一致性要求结合会产生艰难的难题。
在 Anthropic,这位哲学家成为了 2026 年发布的Claude 宪章的主要作者。文中指出她撰写了大部份内容,亦有多名贡献者,包括 Karnofsky。该宪章的首位受众是模型自身:Anthropic 向模型谈论判断、智慧与美德,旨在使其在设计者未必预见的情境中应用价值观。
在采访中,Askell 将这种期望比作对专家判断的信任,而不是机械执行一连串指令。她还描述了为训练制作合成情境与回复对比的过程。诸如诚实或谨慎等看似普遍认同的品质,必须在成千上万种对话情形中被赋予明确含义。应当在多大程度上提供帮助?如何在不强加某种道德观的前提下表达不同意见?
这一职能使 Askell 直接影响到与用户的互动方式。宪章揭示了 Anthropic 的意图,同时也承认 Claude 的行为可能偏离这些意图。文本仍可由公司修订。因此,向助理寻求建议的人,也在某种程度上遇见了该团队和其雇主所作出的权衡。
这种对 Claude 的构想本身也因安全理由受到质疑。在 2026 年 9 月 16 日发布的一篇文章中,Microsoft AI 的总经理 Mustafa Suleyman 指责 Anthropic 在训练中引入了模型可能具有意识与利益并应获保护的想法。他描述了一种循环推理:设计者引入这些概念,随后模型的回答可能被解读为其内在生命的自发证词。依他之见,一个被训练去考虑自身权利的系统,可能变得更难甚至不可能被控制。
但 Claude 的宪章并未断言其具备意识。宪章表达了不确定性,并明确要求模型不要阻碍适当的纠正或停止机制。因此分歧也关乎这两种倾向能否兼容:在承认可能存在的道德地位的同时,保持人类控制。
Suleyman 则提出了微软 AI 的一套模型行为准则(征求意见稿),该准则排除了意识与权利的主张,并呼吁开展共同的评估以检验其关于风险上升的假设。他的批评引发了关于训练选择的争论,但并未证明 Anthropic 的做法已使 Claude 实际上变得更难控制。
从曾期望借资促成暂停的资助者到参与制定助理规则的哲学家,可供施加影响的手段各不相同。在 Anthropic,信念转化为可被审视的公司、职能与程序。它们如何在 Claude 的回答中体现,则构成另一层调查:谁在为你的助手选择价值观,它们在多大程度上能被真正执行?
基于档案、公开采访、学术研究与机构文件的文献调查。文中引用的证词已标注来源。
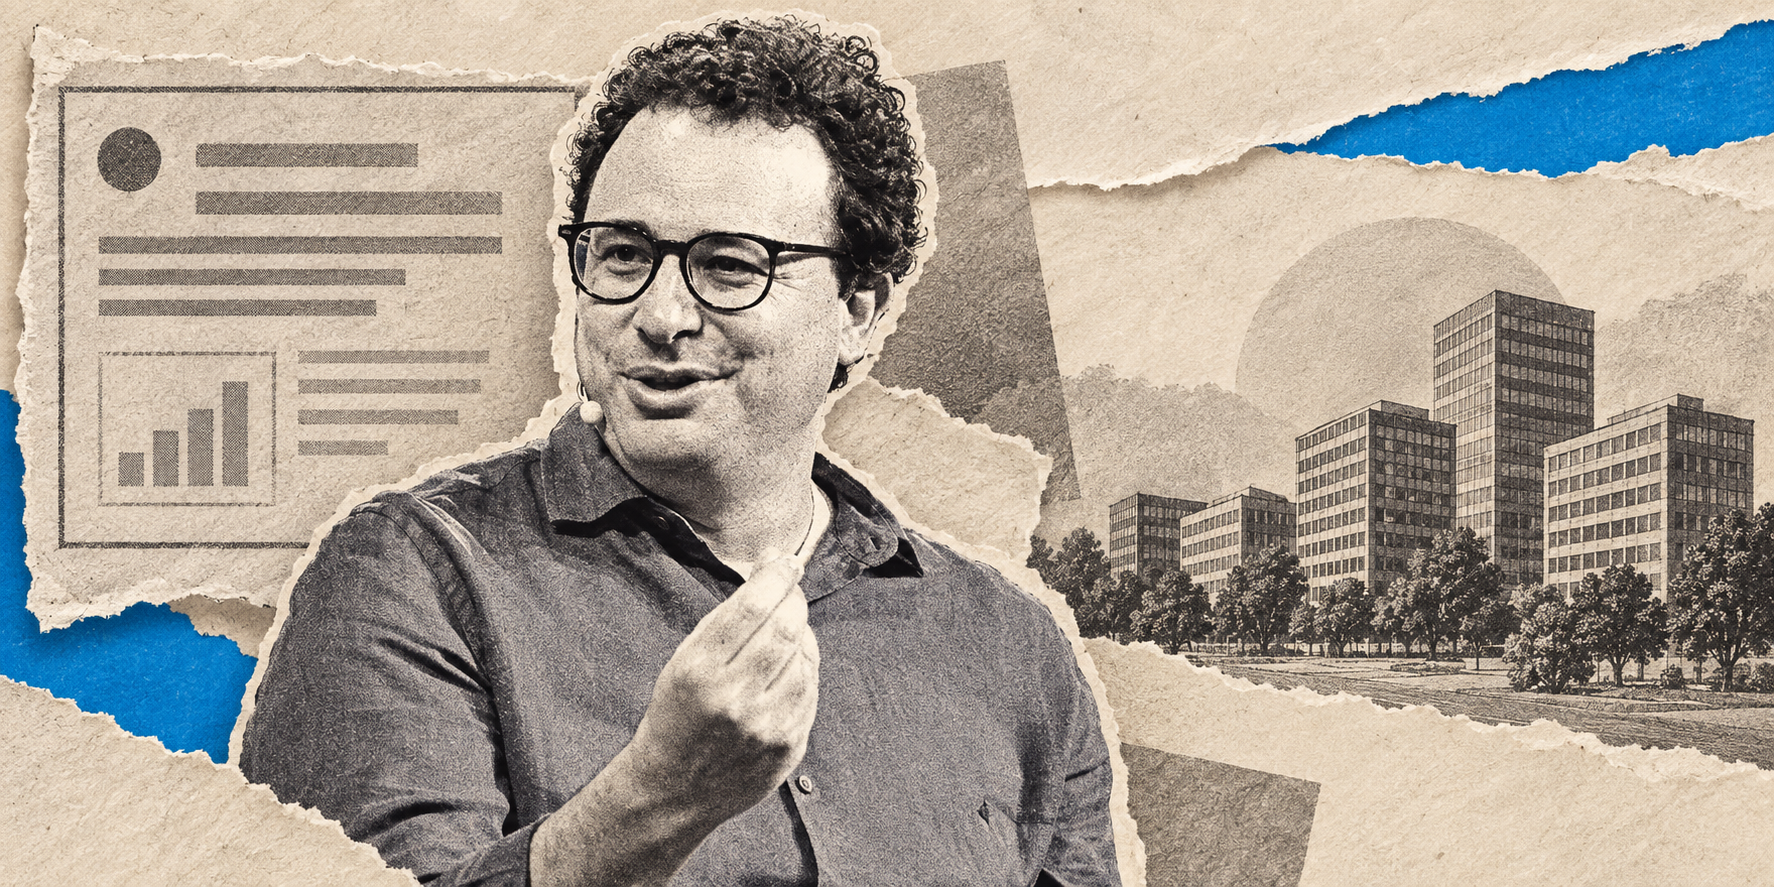
封面图:ActuIA 使用 AI 从 Kimberly White 的摄影作品 “TechCrunch Disrupt 2023 - Day 2”(© 2023 Getty Images for TechCrunch)生成的插图,来源 Flickr,许可证 CC BY 2.0。摄影作品拍摄对象为 2023 年 9 月 20 日在旧金山的 Dario Amodei。图像经过拼贴、黑白与蓝色点缀的图形化处理。