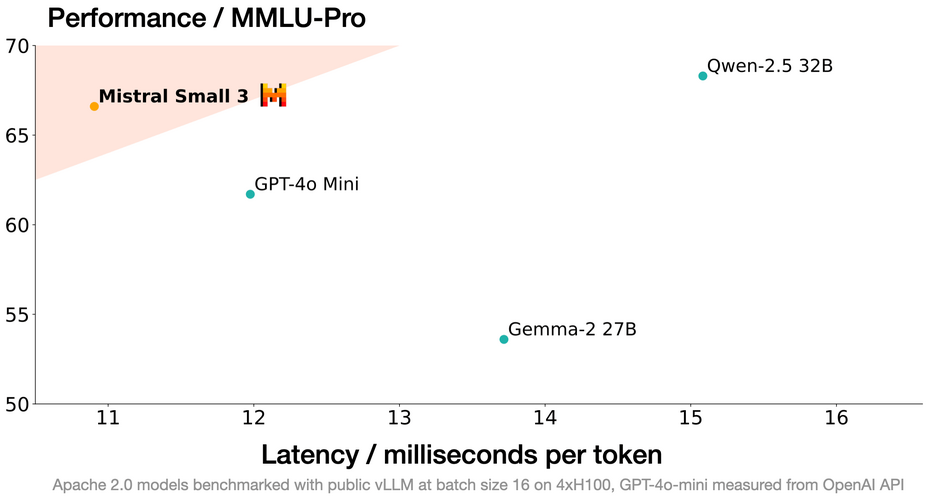
 この技術的な偉業は、従来の層の数を減らす最適化されたアーキテクチャによって実現されており、応答の質を損なうことなく、フォワードパス時間(ニューラルネットワークモデルが入力を処理し出力を生成するのに必要な時間)を短縮しています。
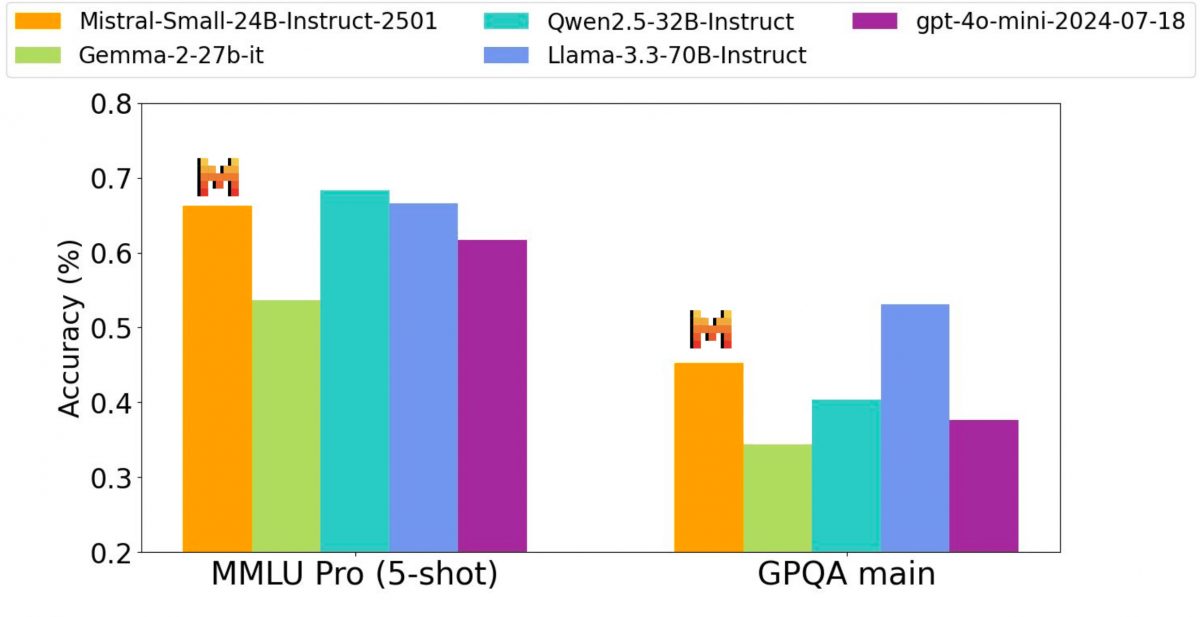
このアーキテクチャの選択により、「現在そのカテゴリで最も効率的なモデル」となっており、最適化バージョンのMistral Small 3 Instructは、Llama 3.3 70BやQwen 32Bのようなはるかに大きなモデルと競合し、標準ハードウェアでの迅速かつ効果的な実行を保証します。
多様なセクターへの応用
Mistral Small 3は、技術的な性能の高さを示すだけでなく、企業の具体的なニーズに適応するための柔軟性も持っています。想定されるユースケースの中で、いくつかの分野が際立っています:- 会話アシスタンスと機能呼び出し:低遅延がリアルタイムのインタラクションを保証し、チャットボットやバーチャルアシスタントにとって不可欠です;
- 特定の専門分野に対する微調整:小さなサイズが診断医療や法的アドバイスのような特定の分野に対する微調整を容易にします;
- ローカル推論:モデルをアクセス可能なハードウェアに展開することで、デリケートなデータがローカルで処理される必要があるセクターでの使用を促進します。
オープンで協力的な配信戦略
Mistral AIによると、DeepSeekとOpen-R1プロジェクトの最新モデルに言及し、「オープンソースコミュニティにとってエキサイティングな日々でした!Mistral Small 3は、DeepSeekの最近のバージョンのような大規模なオープンソース推論モデルを補完し、推論能力を発展させるための強力な基盤モデルとして役立つことができます」と述べています。 この企業は、Apache 2.0ライセンスの下で公開することを選択し、一般使用モデルに対するより制限的なMRLライセンスを徐々に放棄する決定をしました。「今後数週間で改善された推論能力を持つ小型および大型のMistralモデル」を発表する予定です。 現在、Hugging Face、Ollama、Kaggle、Together AI、Fireworks AIで利用可能なMistral Small 3は、NVIDIA NIM、Amazon SageMaker、Groq、Databricks、Snowflakeでも間もなく利用可能になります。
Google のトップニュースで記事が優先表示されます。