최적화된 후속 교육
Tülu 3 405B의 후속 교육 방식은 AI2가 작년 11월에 발표한 Tülu 3 8B 및 70B와 유사합니다. 이는 데이터의 세심한 선별, 감독된 미세 조정(SFT), 직접 선호 최적화(DPO) 및 검증 가능한 보상에 의한 강화 학습(RLVR)을 포함합니다.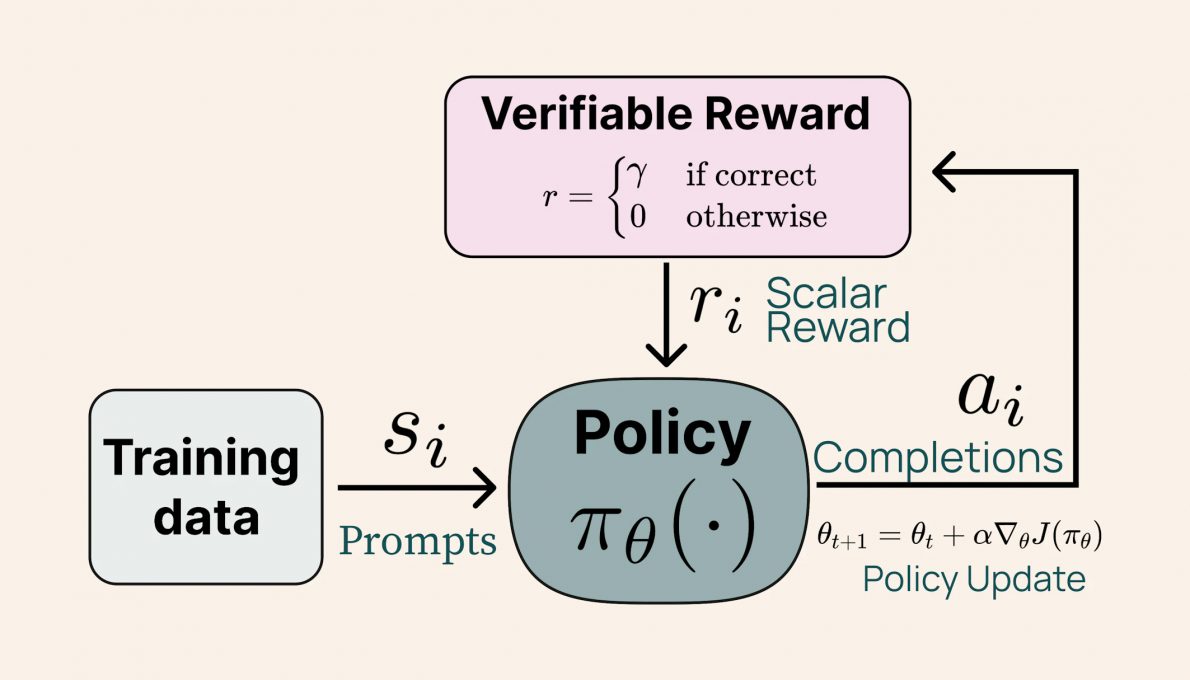 AI 제공 이미지. 검증 가능한 보상에 의한 강화 학습(RLVR) 프로세스를 설명하는 다이어그램. 이 새로운 방법은 수학 문제 해결 및 지침 추적과 같은 복잡한 작업에서 Tülu 모델의 성능을 크게 향상시킵니다. 흥미롭게도, 결과는 모델의 규모가 RLVR의 효율성에 긍정적인 영향을 미친다는 것을 보여줍니다. 더 작은 모델은 다양한 데이터 세트에서 훈련을 받는 반면, Tülu 3 405B는 더욱 전문화된 데이터에 집중하여 더 나은 성능을 발휘합니다.
모델 성능
AI2의 내부 평가에 따르면, Tülu 3 405B는 14,000개의 질문-답변 쌍으로 모델의 정보 회수 및 생성 능력을 검증하는 PopQA 벤치마크에서 DeepSeek V3, GPT-4o 및 Llama 3.1 405B를 능가했습니다. 이 모델은 또한 OpenAI가 만든 약 8,500개의 학업 수준 수학 문제로 구성된 GSM8K에서 해당 범주에 속한 모든 모델 중에서 가장 높은 성능을 기록했습니다. 이는 다단계 수학적 추론을 수행하는 언어 모델의 능력을 테스트하기 위한 것입니다.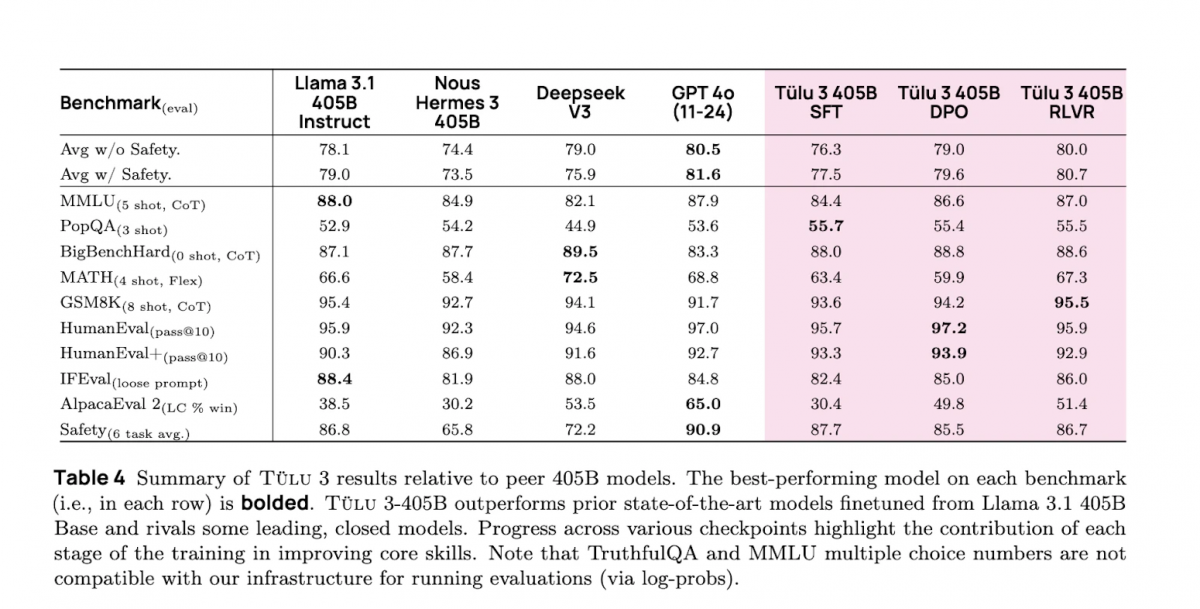
기술적 과제 및 구현 도전
모델의 확장은 도전 과제가 없었던 것은 아닙니다. Tülu 3 405B의 훈련에는 병렬로 배치된 256개의 GPU가 필요했습니다. 텐서 병렬성 관리 및 하이퍼파라미터 최적화는 중요한 포인트였으며, 엄격한 모니터링이 요구되었습니다. NCCL(NVIDIA Collective Communications Library, 데이터 교환과 관련된 병목 현상을 줄이고 시스템의 전체 성능을 향상시키는 오픈 소스 라이브러리)의 전파를 위한 수정 사항의 통합은 모델 가중치의 효율적인 동기화를 가능하게 하여 추론 및 업데이트 지연을 줄였습니다. Tülu 3 405B는 오픈 소스 AI에 대한 OSI의 정의를 충족하는 진정한 오픈 모델입니다. 모델은 AI2 웹사이트에서 테스트할 수 있으며, Hugging Face에서 접근 가능하고, GitHub에서 훈련 코드를 확인할 수 있습니다. 모델은 Google Cloud에 호스팅되며, 곧 Vertex AI에서 사용 가능합니다.
Google 주요 뉴스에 기사가 우선 표시됩니다.