

优化的后训练
Tülu 3 405B的后训练配方与其前代产品Tülu 3 8B和70B相似,这些产品由AI2在去年11月发布。它包括数据的精细筛选、监督微调(SFT)、直接偏好优化(DPO)以及可验证奖励的强化学习(RLVR)。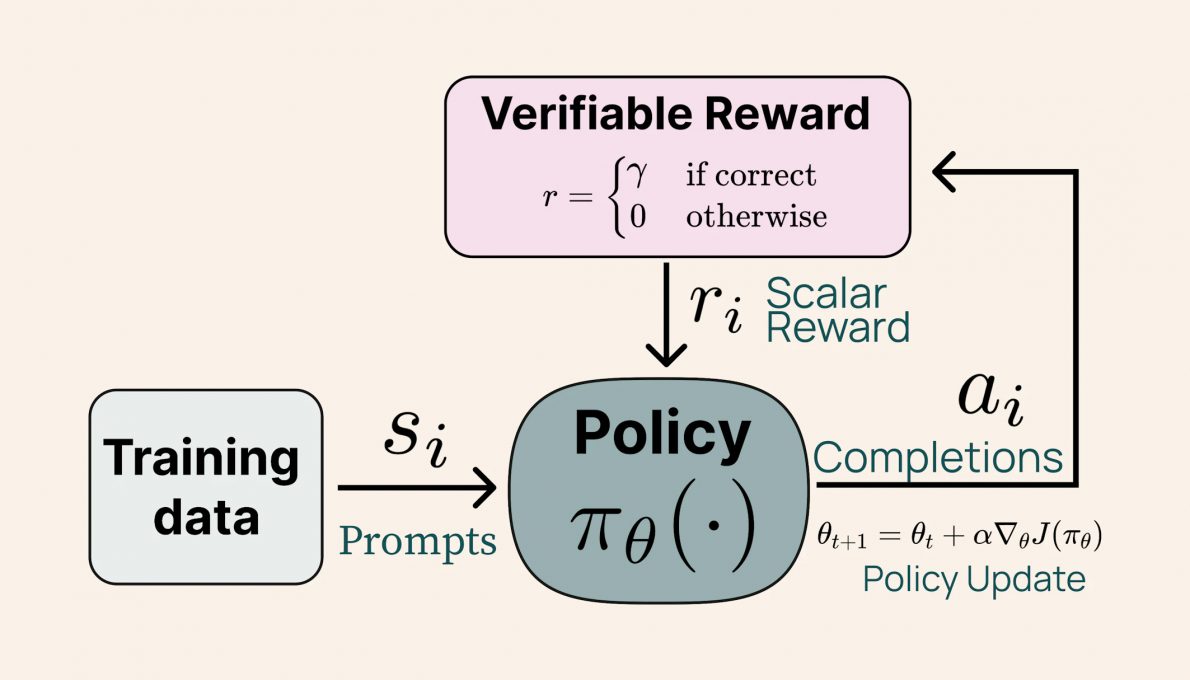 AI提供的图片。描述可验证奖励强化学习(RLVR)过程的示意图。 这种新方法显著提高了Tülu模型在解决复杂任务如数学问题解决和指令遵循方面的性能。值得注意的是,结果表明模型的规模对RLVR的有效性有正面影响:虽然较小的模型从多样化数据集训练中受益,Tülu 3 405B通过专注于更专业的数据获得了更好的性能。
模型性能
根据AI2的内部评估,Tülu 3 405B在PopQA基准测试中超过了DeepSeek V3、GPT-4o和Llama 3.1 405B,PopQA是一个包含14,000个问答对的集合,用于验证模型在信息检索和生成方面的效率。该模型还在GSM8K上取得了该类别所有模型中最高的性能,GSM8K是由OpenAI创建的一个约8,500个学校级数学问题的数据集,用于测试语言模型执行多步骤数学推理的能力。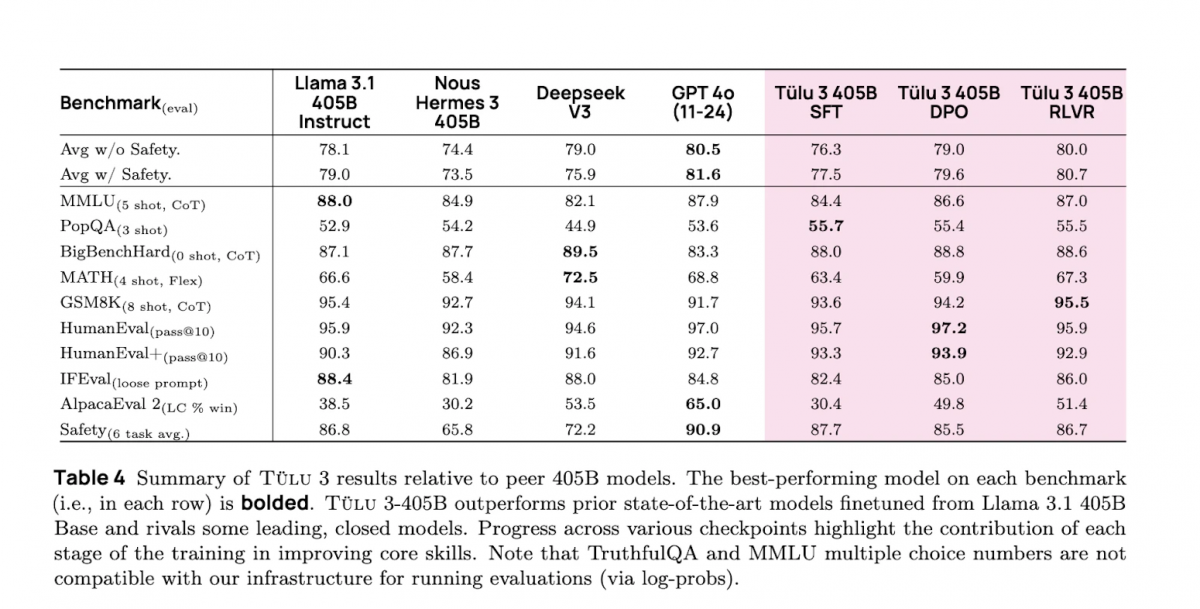
技术挑战与实施难点
模型的扩展并非没有挑战。Tülu 3 405B的训练需要大量的基础设施,256个GPU并行部署。张量并行性的管理和超参数的优化是关键点,需进行严格监控。然而,通过整合NCCL(NVIDIA集体通信库,一种开源库,能够减少数据交换相关的瓶颈并提高系统的整体性能)的修正,有效同步了模型权重,从而减少了推理和更新的延迟。 Tülu 3 405B是一个真正的开源模型,符合OSI的开源AI定义OSAID的严格标准。它可以在Ai2网站上测试,在Hugging Face上访问,其训练代码在GitHub上。 托管在Google Cloud上,该模型将很快在Vertex AI上线。
我们的文章将优先显示在 Google“头条新闻”中。